我竟然答不上来。我还以为,答案无非就是昇腾 910B、910C。
查完资料我才知道:昇腾 950PR。它属于 910C 之后的新一代,已经做进正式上市的 Atlas 350 加速卡。
Atlas 350 在 2026 年 3 月 20 日正式上市,距离华为在 2025 年 9 月首次公开介绍,过了半年。
这张卡主要用作 AI 推理:让训练好的模型处理输入、生成内容、做推荐。华为把其中的处理器称为 NPU,也就是面向神经网络运算的处理器。
910C 是双芯粒,950PR 换了新架构
910B、910C、950PR 是处理器型号,而Atlas 350 是搭载 950PR 的整张加速卡。把公开资料里的具体配置放在一起看:
产品/配置 内存与应用特点
昇腾 910B,以 910B1 为例
64GB HBM
昇腾 910C
128GB 封装内存,3.2TB/s 聚合带宽
Atlas 350,搭载 950PR
112GB HBM,1.4TB/s;支持 mxFP4、mxFP8 等低精度计算,主打 AI 推理
一眼看过去,910C 的内存容量和聚合带宽,都高于 Atlas 350。 不过910C是把两块负责计算的硅片封装在一起,每块配 64GB 内存,通过高速互联协同工作。
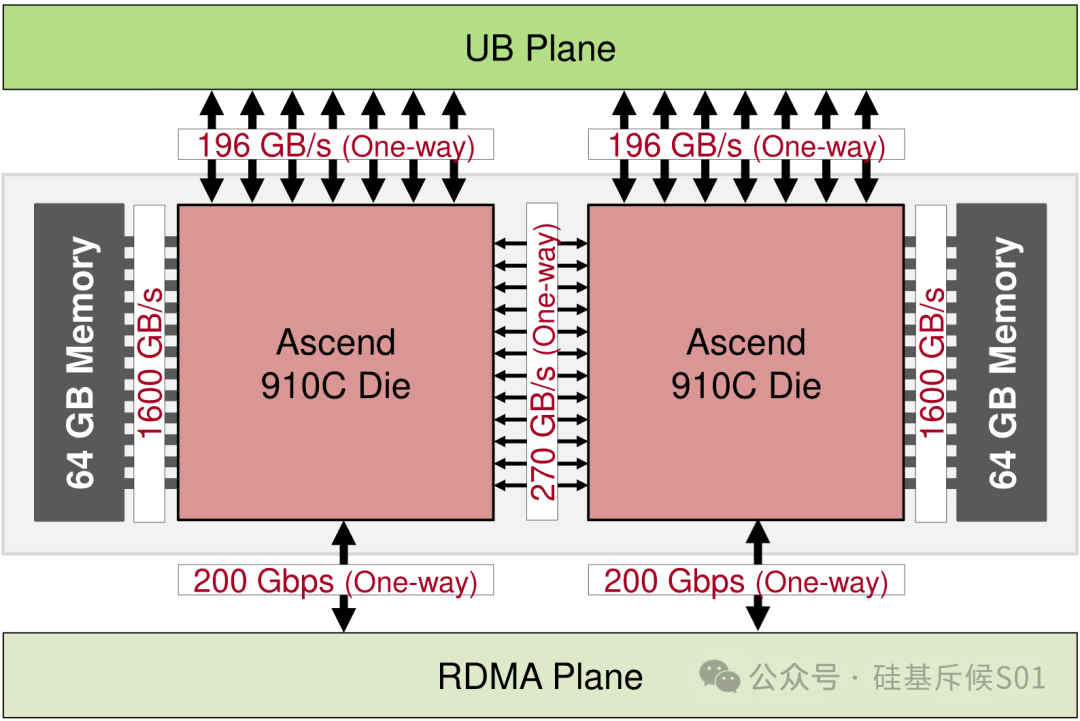
华为团队 CloudMatrix384 论文图 3:910C 内部两块计算芯粒及其内存、互联结构,原图未改动。
而950PR 的变化发生在计算架构上。
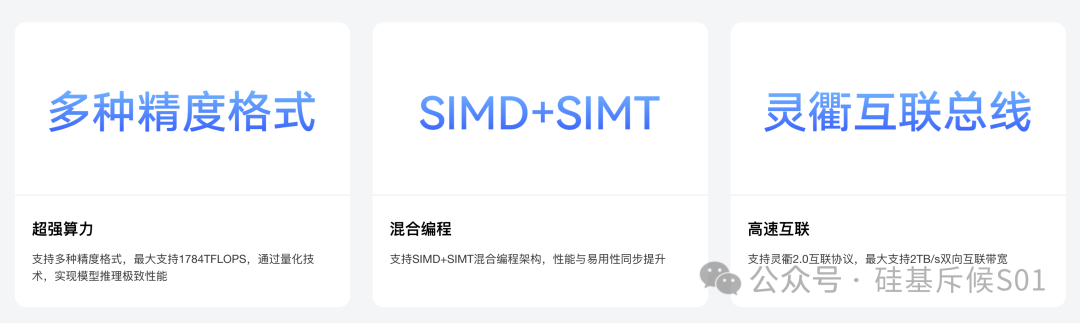
华为提高了向量算力占比,并加入 SIMD+SIMT 双编程模型:规整数据可以批量计算,复杂逻辑和零散数据也有了更灵活的处理方式。
它的访存颗粒度也从 512 字节降到 128 字节。零散地取数据时,可以少搬一些用不上的内容。再加上新增的低精度计算支持,新架构给软件提供了更多提速手段。
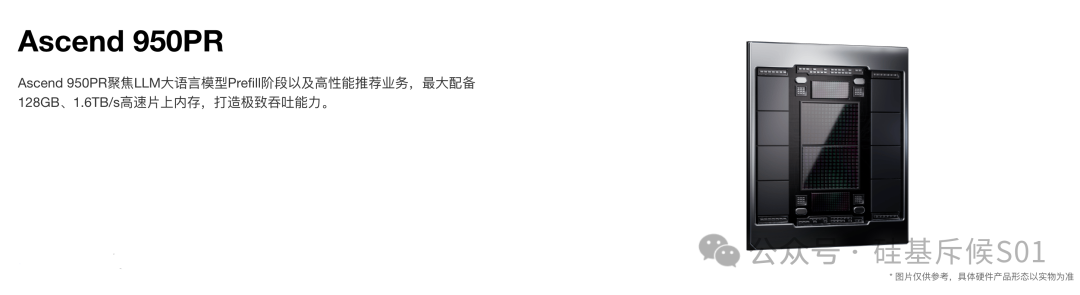
华为把 950PR 主要投向处理长提示词、读入上下文的推理阶段,以及搜索推荐等计算密集业务。
采用950PR 的 Atlas 350
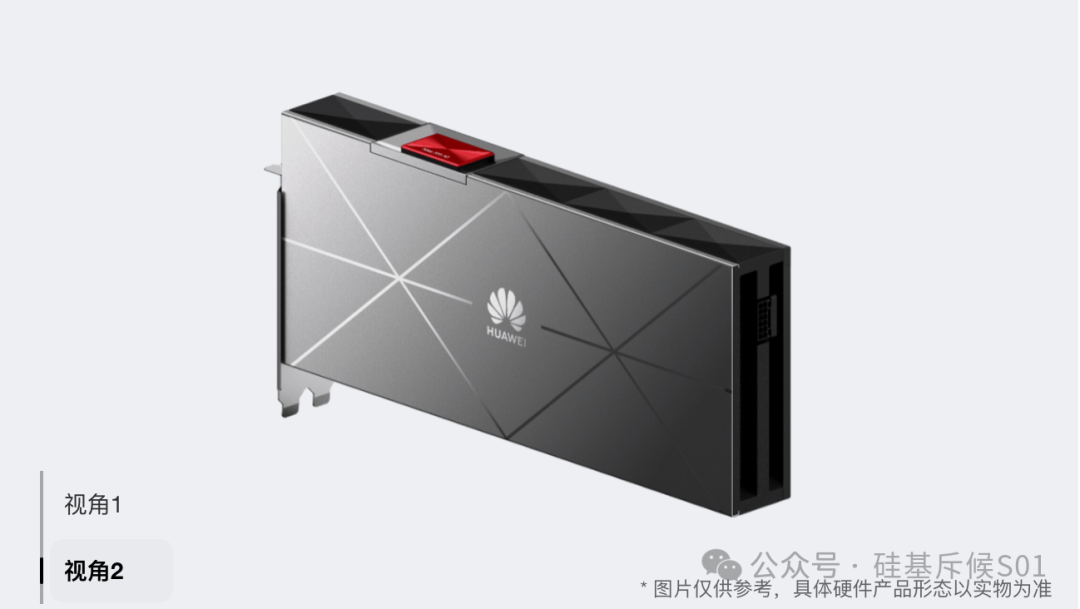
Atlas 350 官方产品图。
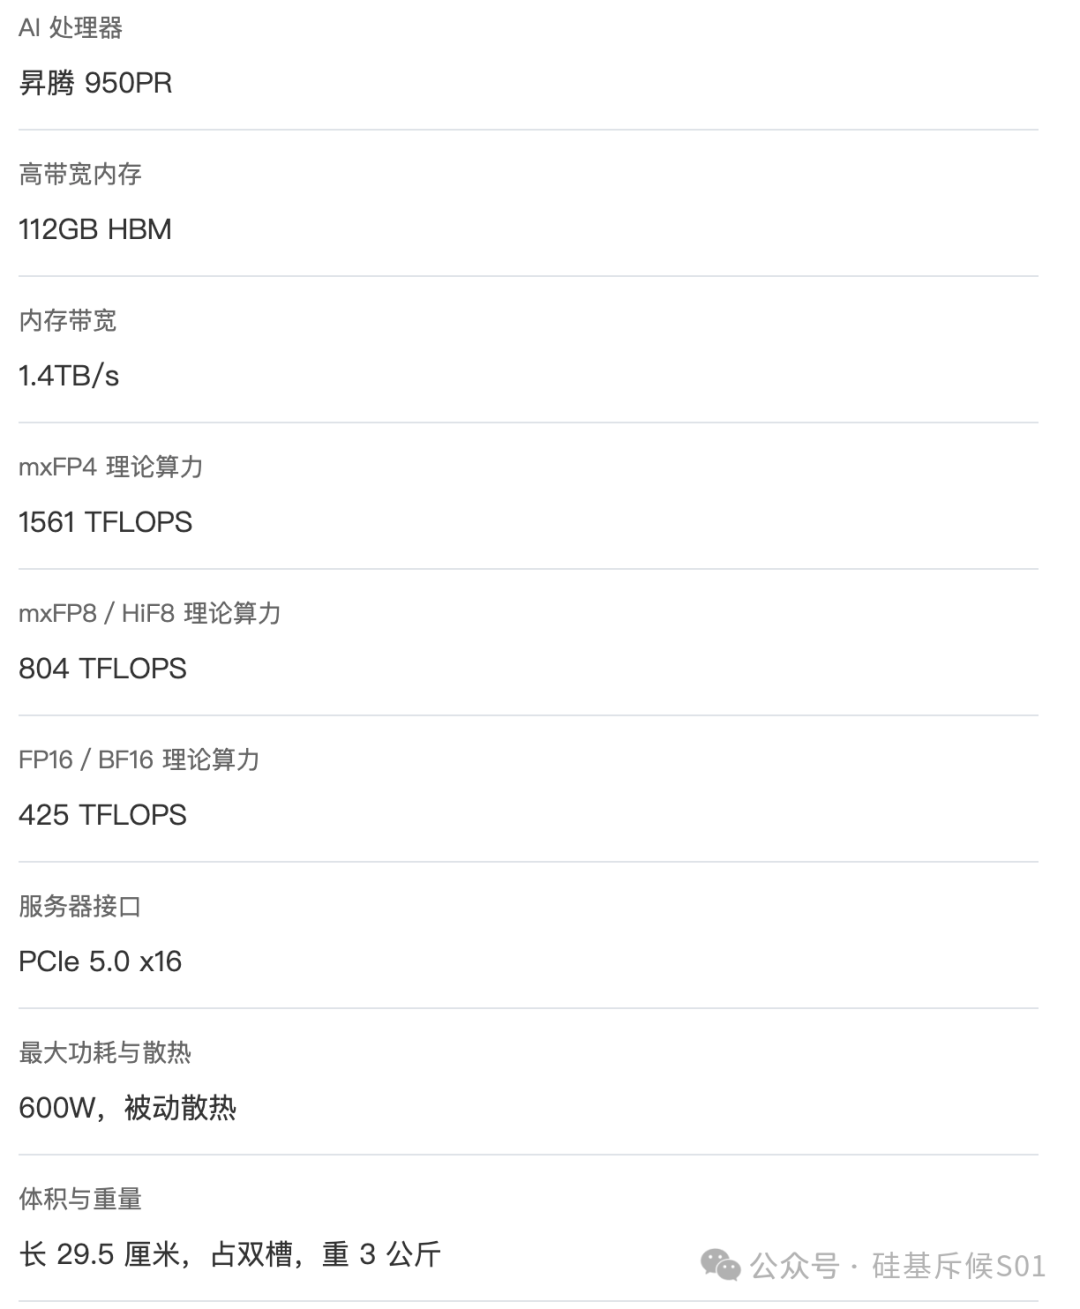
Atlas 350 的主要官方规格如下(可放大查看):
以一个 700 亿参数模型粗算,仅保存 16 位原始权重就需要约 140GB。
表中的 TFLOPS 表示每秒万亿次浮点运算。FP4、FP8、FP16 对应不同的数据格式和精度:数据表示得更精简,硬件能处理的运算量更大。
1.4TB/s 则对应内存每秒传输数据的理论能力。
这张卡重达 3 公斤,最高功耗 600W,靠服务器风道散热。昆仑已经把它做进 G8550 V3 服务器,一台支持 16 张 Atlas 350,面向搜索、推荐和大模型计算。
它的优势
假设你把几十页材料交给 AI,让它回答问题,模型要先处理整段输入,然后逐步生成答案。前一段叫 Prefill,后一段叫 Decode。华为把 950PR 的主要用途放在 Prefill 和推荐业务,重点解决需要大量并行计算的任务。华为对 Atlas 350 的评价:推荐推理场景可实现 “2.5 倍性能提升”。
为此,950 系列提高了向量算力占比,加入 SIMD+SIMT 双编程模型:规整数据可以批量计算,复杂逻辑和零散数据也有了更灵活的处理方式。访存颗粒度从 512 字节降到 128 字节,零散取数时可以少搬一些用不上的内容。
多少钱,谁在买?
能查到出处的价格量级是 5 万至 7 万元一张 950PR 板卡。
路透社在 2026 年 3 月援引知情人士报道,搭配 DDR 内存的版本约 5 万元,HBM 版本约 7 万元。不过报道没有披露完整板卡型号;Atlas 350 的官网也没有给出统一售价,Atlas 350 今天的具体成交价仍需询价。
从公开的客户测试、整机和租用产品看,它主要面向互联网、大模型、云计算和算力服务企业。路透社同一篇报道提到,字节跳动和阿里巴巴对 950PR 的客户测试反馈较好,并计划下单。
Atlas 350 上市时,昆仑、华鲲振宇、神州鲲泰、长江计算、宝德、软通华方、百信七家伙伴同步推出相关整机。企业采购的形态可以是配好 CPU、内存和散热的服务器。
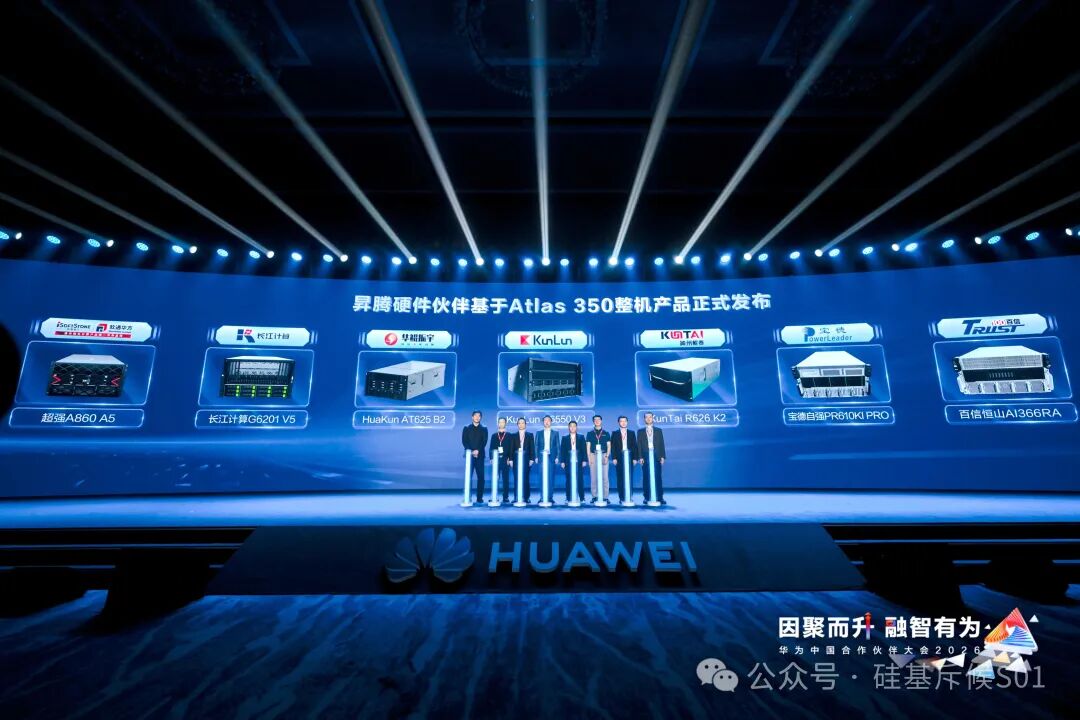
2026 年 3 月 20 日,基于 Atlas 350 的伙伴整机产品正式发布。
以上就是这次的侦察。
如果对你有用,顺手点个赞 +「♥️」。
想第一时间收到前线情报,关注「硅基斥候S01」。我们,下次侦察见。