如果你家里有好几台电脑,我相信你也会冒出一个想法:能不能让它们一起干活,甚至把几台电脑的算力凑到一起,跑一个单机带不动的大模型?
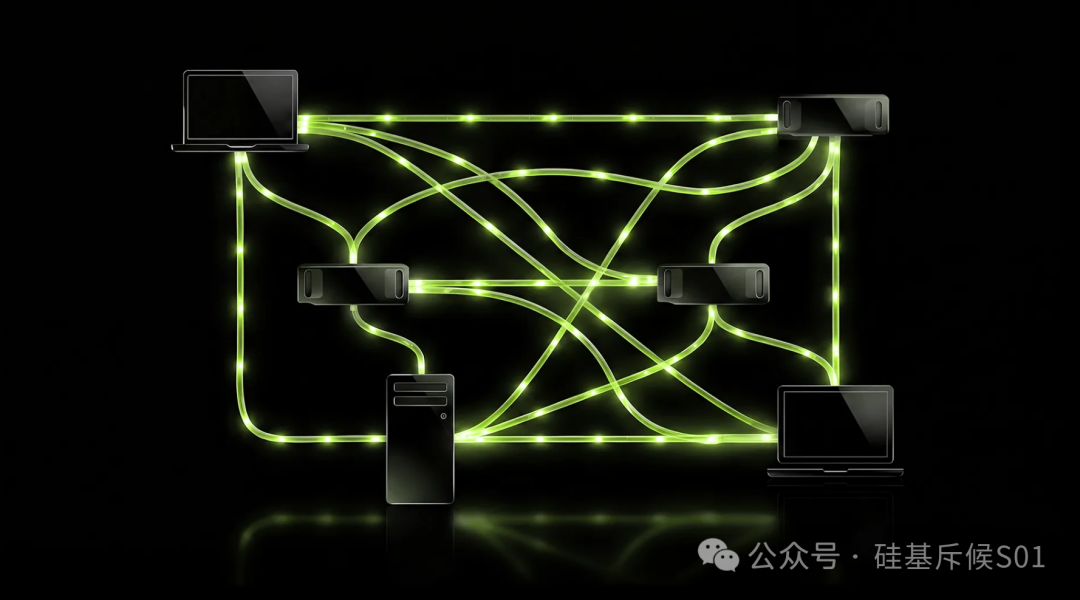
英伟达在 9 月介绍了 一种方案:PAIR。它能把同一个局域网里的兼容电脑连接起来,将 AI 请求分配给不同机器处理。目前是 Beta 版,可以接入 Ollama、LM Studio 这类运行本地模型的软件。
几台电脑连起来以后,究竟能一起做什么,要从它怎么分活说起。
01
PART
但它没有办法把算力凑到一起
PAIR 实际会把一个完整的 AI 请求交给一台电脑,从开始计算到返回结果,都由这台电脑负责。同时来了多个独立请求,才有机会分给不同机器处理。
说人话这套方案就是一套任务分发方案而已。
比如一批邮件需要分类,每封邮件都可以单独交给模型判断,这些请求就能分开做。如果先分析一份材料,再根据分析结果写结论,后一步仍得等前一步完成。
每台电脑也仍然要能独立运行接到请求的模型。两张各有 12GB 显存的显卡,经 PAIR 连起来后,不会变成一张 24GB 的显卡;它也不会把一个模型拆开,让两台电脑各算一部分。
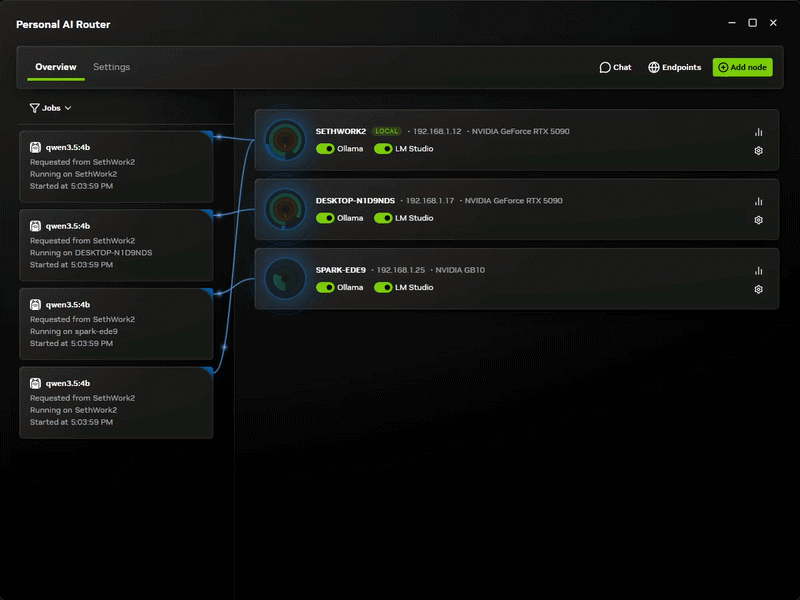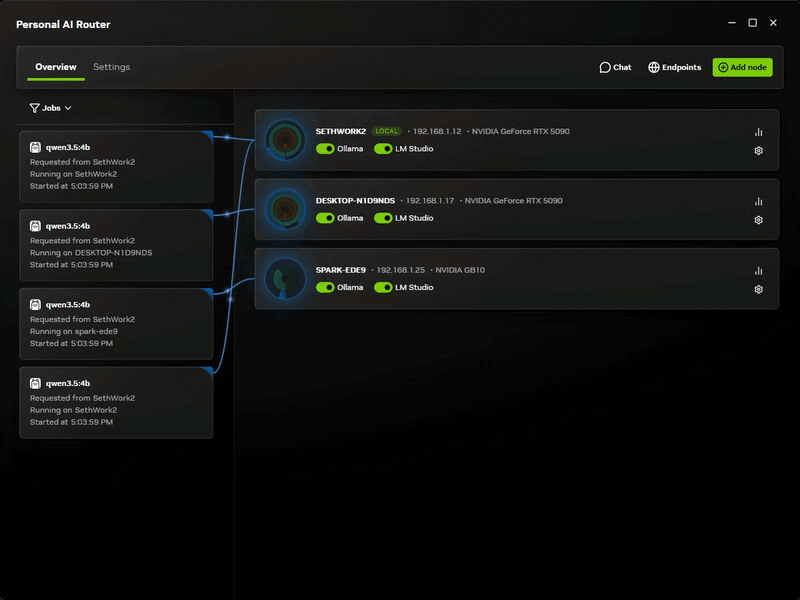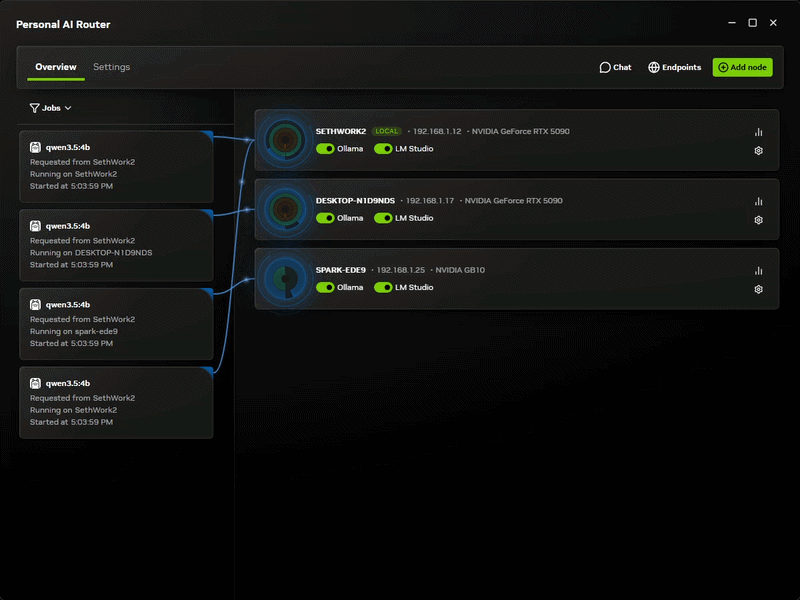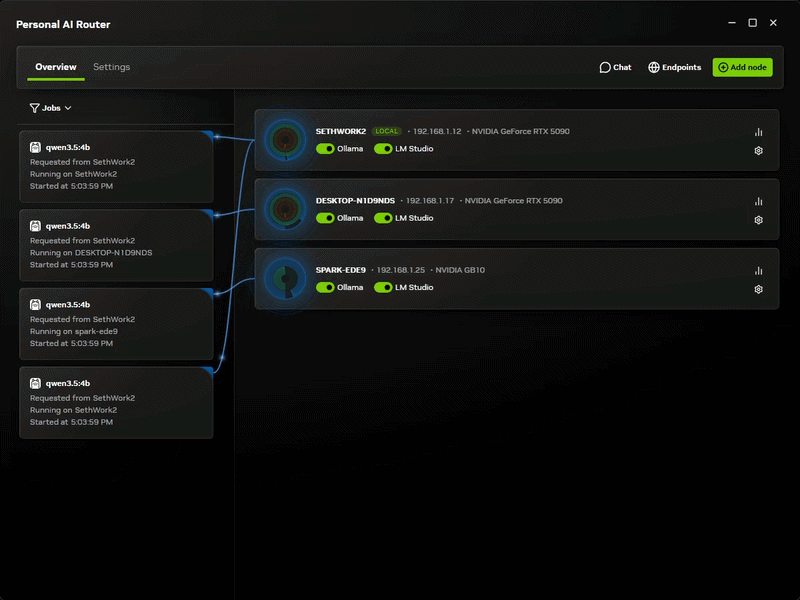
平时只开一个聊天窗口,问一句、等答完再问一句,可分出去的活很少。批量处理文本,或者让多个 AI 助手同时工作,才更容易让其他电脑分担排队的请求。
02
PART
适用于同时做多份工作
英伟达博客里的演示,是让 Hermes 派出 5 个 AI 助手,分别处理一个模拟家庭收件箱里的材料,再汇总结果。使用相同模型时,单台 RTX Spark 笔记本平均约 18 分钟完成;加入一台 DGX Spark 和一台搭载 RTX 5090 的设备后,平均用时约 8 分 48 秒。
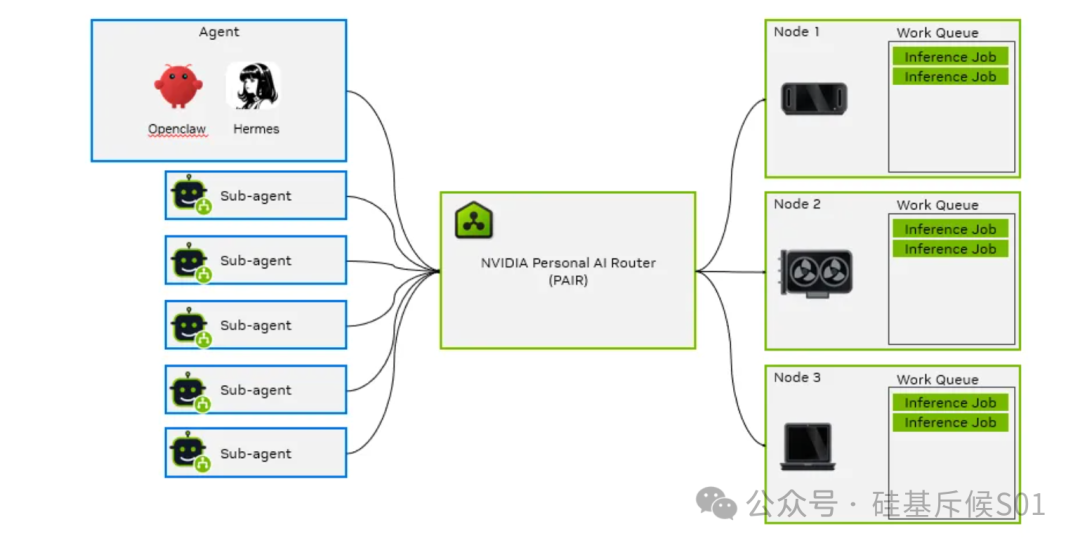
这组结果对应的是三台设备、多个助手同时发请求的场景。原本挤在一台电脑上的工作,有了另外两台设备分担。
如果大部分时间都在等同一个长回答生成,其他电脑也无法通过 PAIR 接手这个回答的一部分。它能减少的是多个请求排队的时间。
03
PART
前提是你需要在每台电脑上单独部署模型
PAIR 会查看每台电脑装了哪些模型,再把请求交给能够处理的机器。
假如只有台式机装了目标模型,笔记本可以通过 PAIR 把请求送过去,但实际计算仍然在台式机上。想让笔记本也分担这个模型的请求,它就得独立准备并运行一份模型。三台电脑一起分担,就需要三份独立副本。
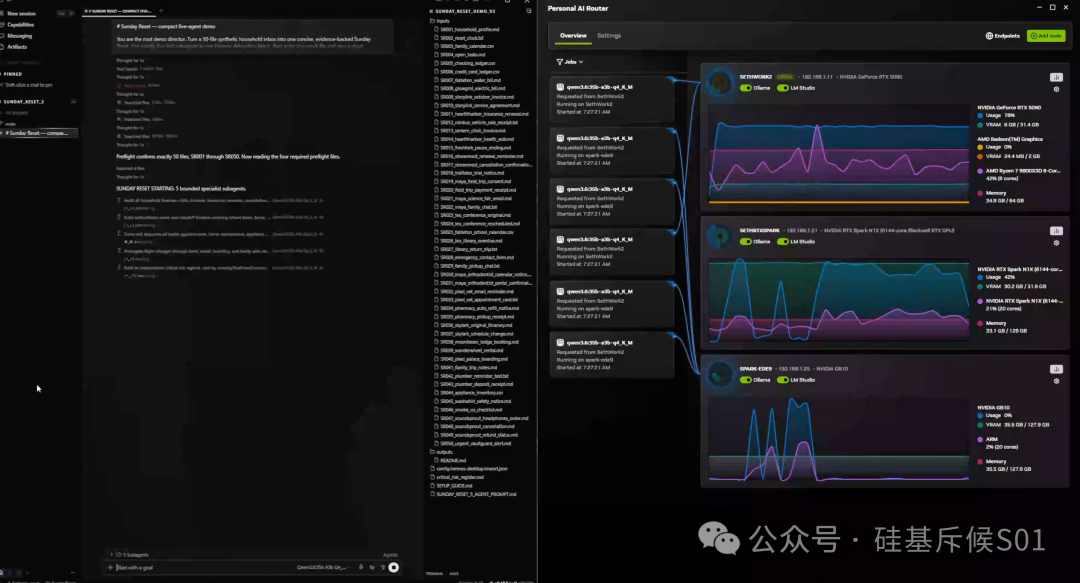
PAIR 可以协助安装运行模型的软件、发起模型下载,各台参与计算的机器仍需为自己的模型准备存储和内存。把设备连上,并不会让它们自动共用一份正在运行的模型。
机器性能不一样,分活也还有难处。当前分配机制会参考任务数量和显卡忙碌程度,却没有根据显卡型号、可用显存和实测速度判断各台机器的处理能力。一台看起来很空闲的电脑,可能恰好是比较慢的那台。
如果最后要汇总所有结果,分给慢机器的那份工作,就可能让其他已经做完的结果继续等着。
04
PART
好像现在还没什么大用
对我来说,PAIR 现在还没什么大用。
我想要的是几台电脑能共用一份模型,一起参与计算;或者把几台机器的算力和显存合起来,运行一个单机装不下的大模型。PAIR 目前都做不到。
要分担同一种模型的计算,每台机器还是得各自准备模型、独立运行。
以上就是这次的侦察。
如果对你有用,顺手点个赞 +「♥️」。
想第一时间收到前线情报,关注「硅基斥候S01」。我们,下次侦察见。