之前写了四篇本体文章,收到一些读者的认可,也让我更有信心继续研究。我想把它做成一个系列,不定期分享自己开发本体系统时遇到的问题、做过的尝试和心得。所有内容都是来自我的自身实践。
这是第五篇,聊聊本体中的推理机。下面是我开发的 IndustrialOntology 本体工程系统,展示制造与冷链场景的合成演示数据。
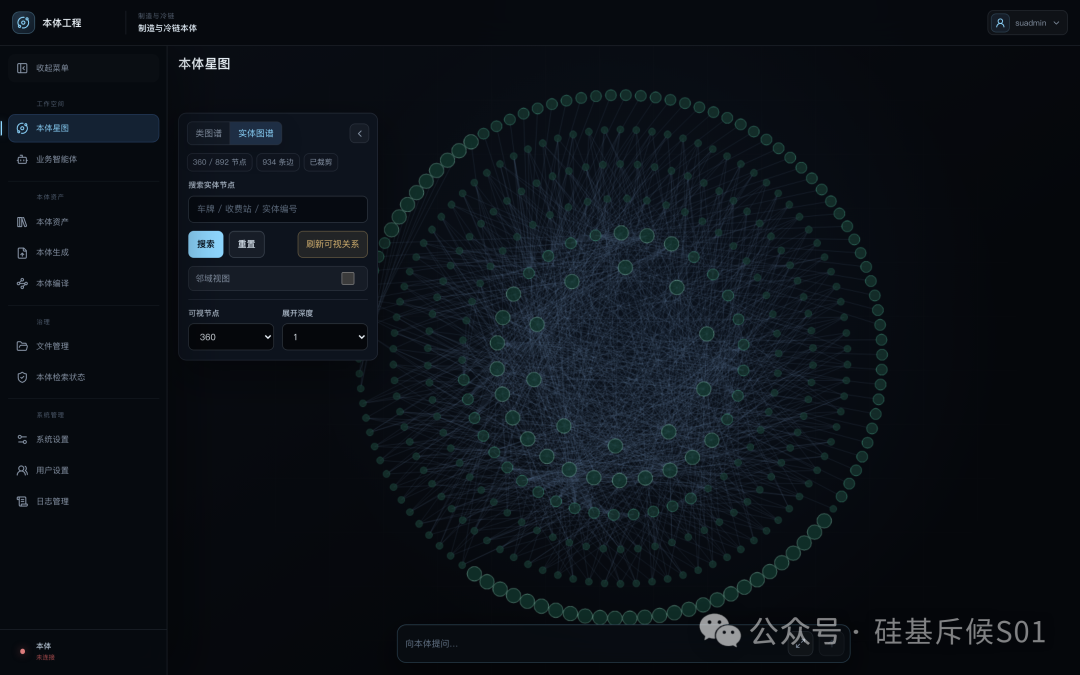
**推理机,是根据明确的逻辑定义和已有事实,计算哪些结论必然成立的软件。**它也能检查规则、事实之间是否存在矛盾。
我们早期用的是自研图谱推理模块,沿对象关系做多跳查询,寻找规则和证据。
后来我开始考虑本体的复用性:项目里建好的本体,能不能作为资产带到下一个项目?
比如,一个交通项目已经定义好了道路、救援站、车辆和人员的关系。到另一个地方应用本体时,我希望导入这份本体,接入当地数据、调整差异规则,减少从头建模的工作。
为了支持导入、导出和融合,我转向了 OWL——表达概念、关系和逻辑约束的标准语言,并找到成熟的推理器 HermiT,让它负责一致性检查、分类和逻辑蕴含判断。
市面上有些本体的文章,我看后是持保留意见的,把图谱接上,再接一个 OpenClaw 之类的 Agent 工具,就说自己做了本体?
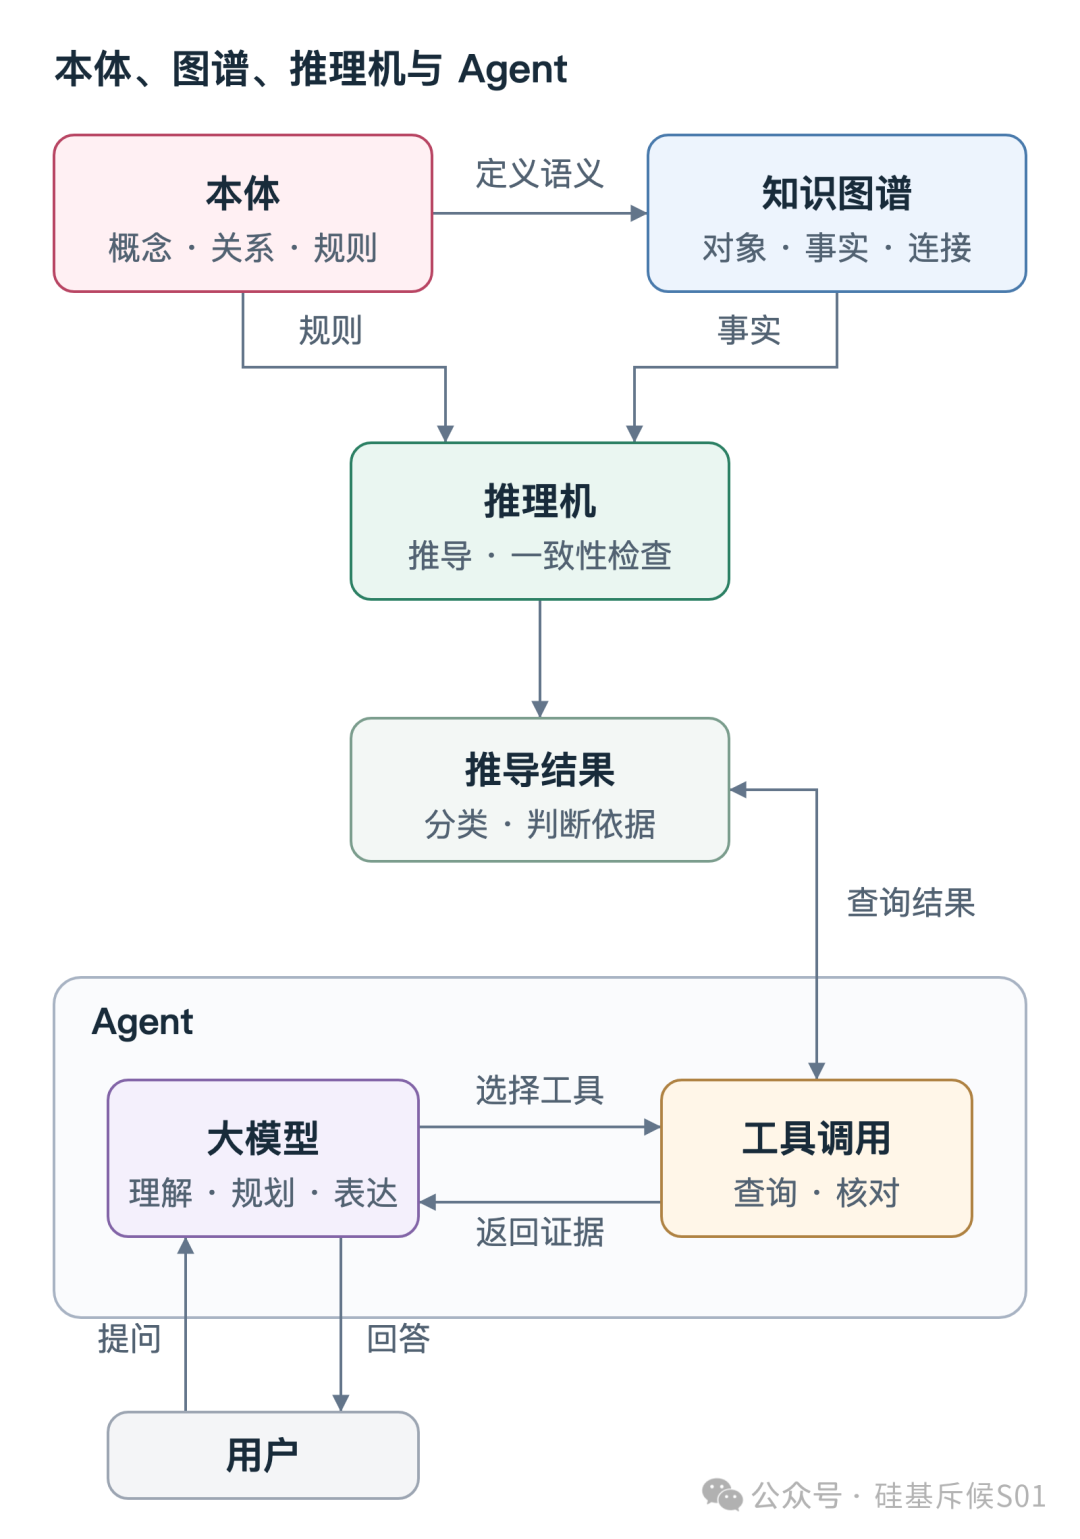
如果只是这个组合,直接让 Agent 查图谱不就行了?到底本体、图谱、推理机、agent 之间,是一个什么样的关系?
一、本体、图谱、推理机和 Agent
**本体定义业务含义与约束。**有哪些对象、彼此是什么关系、什么条件算合格,都在这里说清楚,让系统能按同一套定义处理业务。
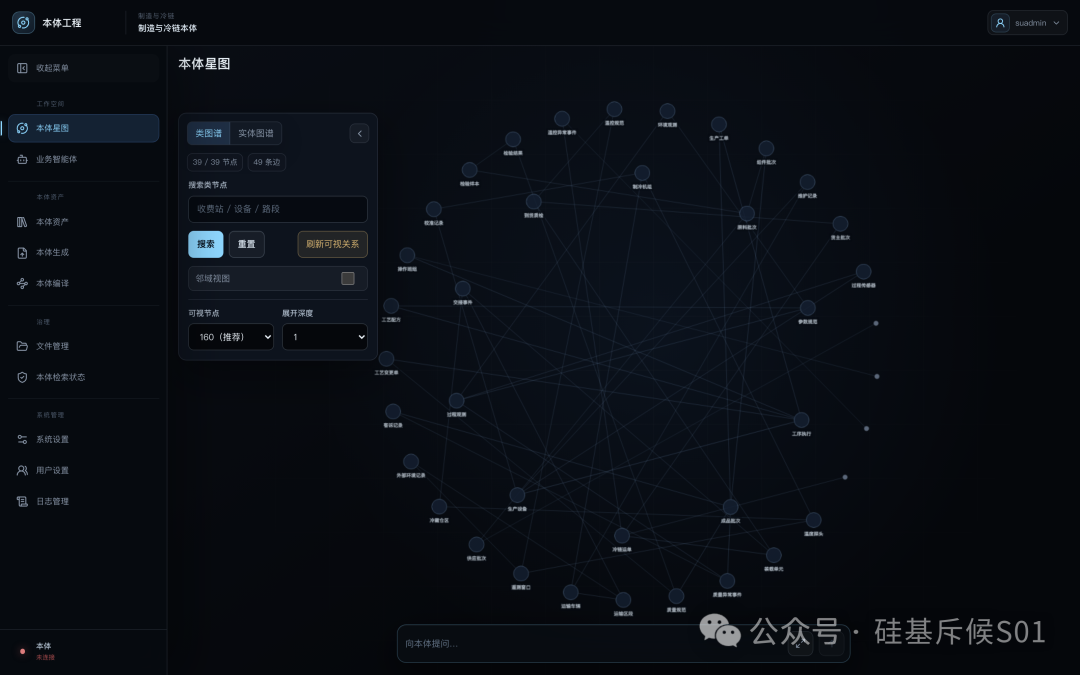
**知识图谱组织对象和事实。**节点可以代表车辆、人员等概念,也可以代表某辆车、某个人;连线表示关系,属性记录状态。它方便查找对象及其关联资料,也可以保存推导结果。
下面是系统的类图谱;切换到实体图谱,查看的就是具体批次、工单和设备。
**推理机,执行逻辑判断。**它按照本体定义计算分类、检查矛盾,区分“符合”“不符合”和“无法确定”。
**Agent,围绕任务调用这些能力。**大模型理解问题、参与选择工具并解释结果;Agent 的运行程序执行调用,再把结果交给模型。
它们组合起来,就是用本体定义业务,用图谱组织事实,用推理机计算结论,再通过 Agent 与大模型回答人的问题。
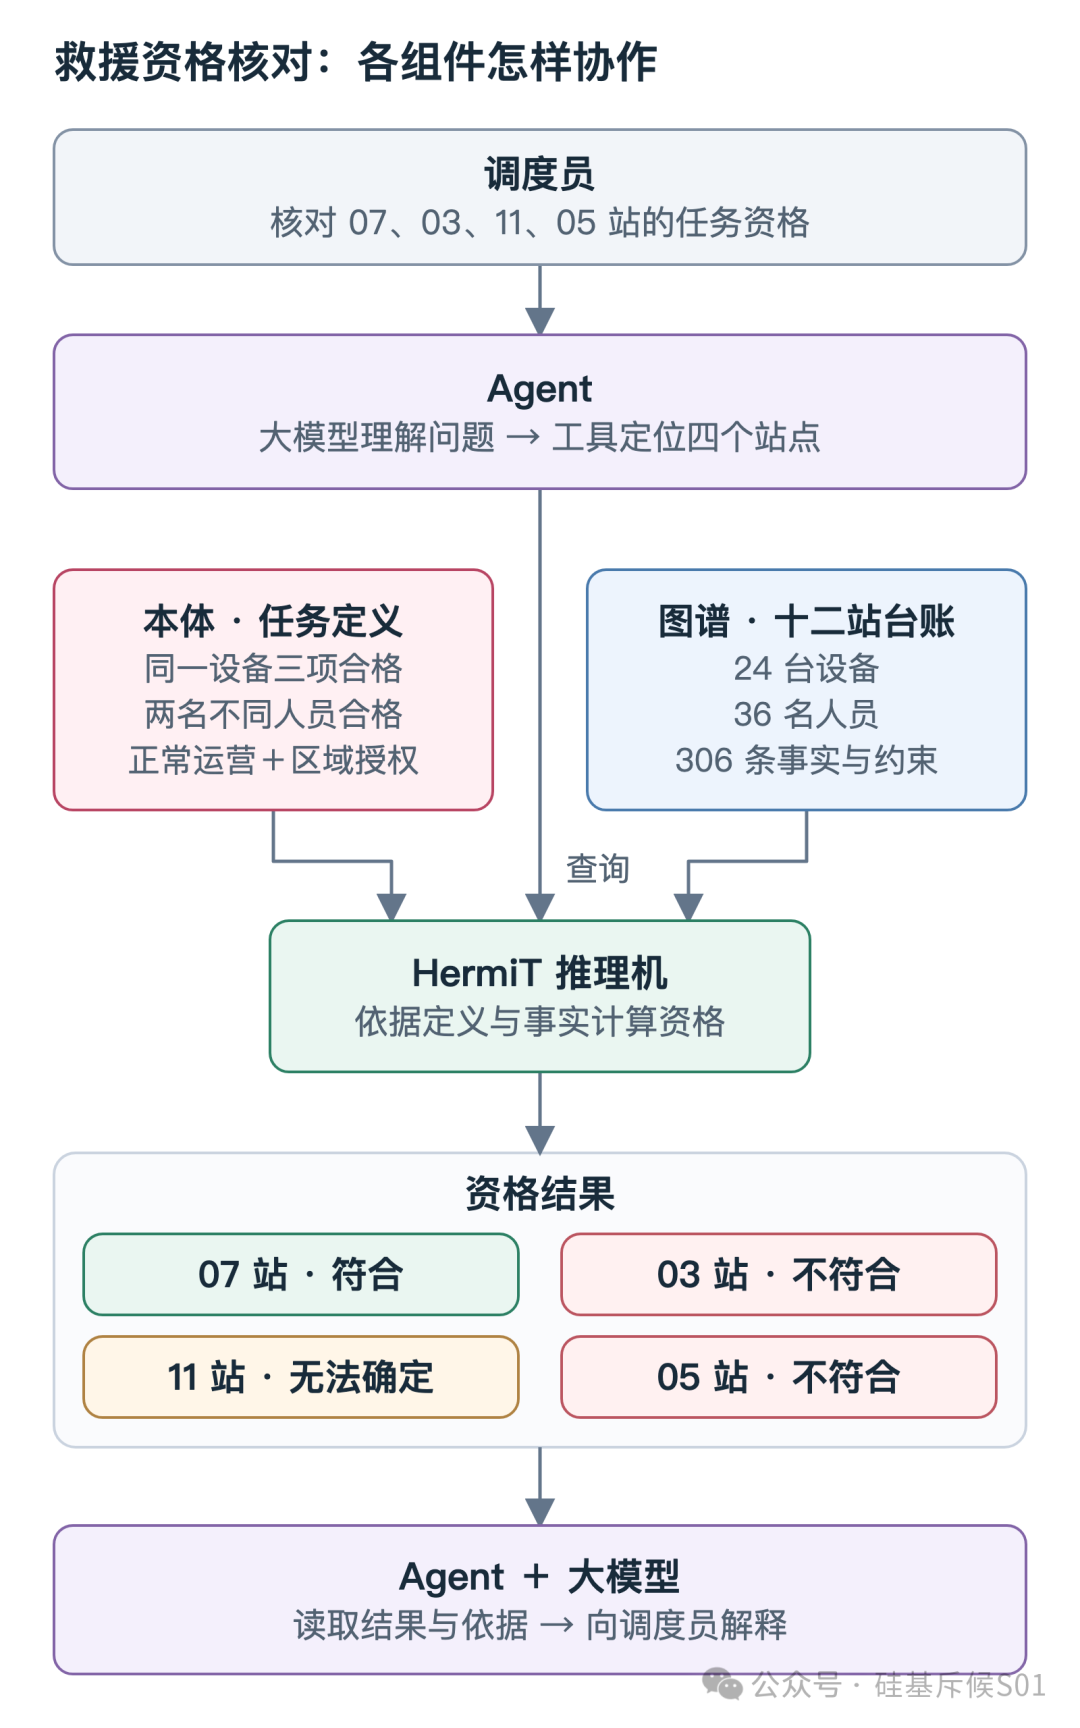
设想高速发生重型车辆事故,调度员派车前,需要核对候选救援站的设备、人员和区域授权。资格通过后,还要结合距离等信息决定派谁去处理。
为模拟这一步,我们构造了十二站台账:24 台设备、36 名人员,共 306 条事实与约束。实验规定,站点必须正常运营、有区域授权;至少一台设备同时满足重型、检验合格、当前可用;至少两名不同人员各自持证、培训合格、当前可用。
本体表达这些条件,图谱组织台账。当调度员要求核对 07、03、11、05 站时,我们希望模型理解问题,Agent 定位对象、取得推理结果,再解释判断依据。完整协作流程如下。
但有一个关键问题,就是现在推理机的必要性:**大模型已经能根据条件进行推理,还需要专门的推理机吗?**如果把全部规则和资料交给模型,是不是不用推理机也能达到实时推理的效果?
二、同一份复杂资料,有没有推理机差多少?
于是,我做了八组同题对照,覆盖十二站台账、人员身份与数量、同一设备的多项条件、五段授权链等。每组四项判断,重复两轮,两种方案各请求 16 次。
两组规则、资料、问题完全相同,都开启思考,限 8,000 token、120 秒;区别是接入组额外拿到 HermiT 实际算出的结果。使用同一个模型服务。
32 次请求的结果
模型自行推导
附推理结果
完整回答且全部正确
6/16 次
14/16 次
输出耗尽,未给答案
6 次
2 次
读取超时
4 次
0 次
**相同预算下,完整正确答复从 6 次增加到 14 次。**两组已经完成的分类都正确,收益体现在更多请求拿到了答案。
HermiT 预先算出了全部 32 项分类,与提前写下的参考答案一致。
同一个结论,推理机计算约 0.34—0.50 秒,而让大模型计算则需要 11-20 秒。
三、推理机怎样处理设备、人员和缺失资料?
推理机是怎么做的?
HermiT 先检查 OWL 定义与事实是否一致,再判断对象满足哪些条件。以 07 站为例:设备同时满足三项要求,得到合格设备;人员持证、培训合格、可用,并且确认彼此不同,得到足够的合格人员;再结合运营状态与授权,推出站点具备资格。
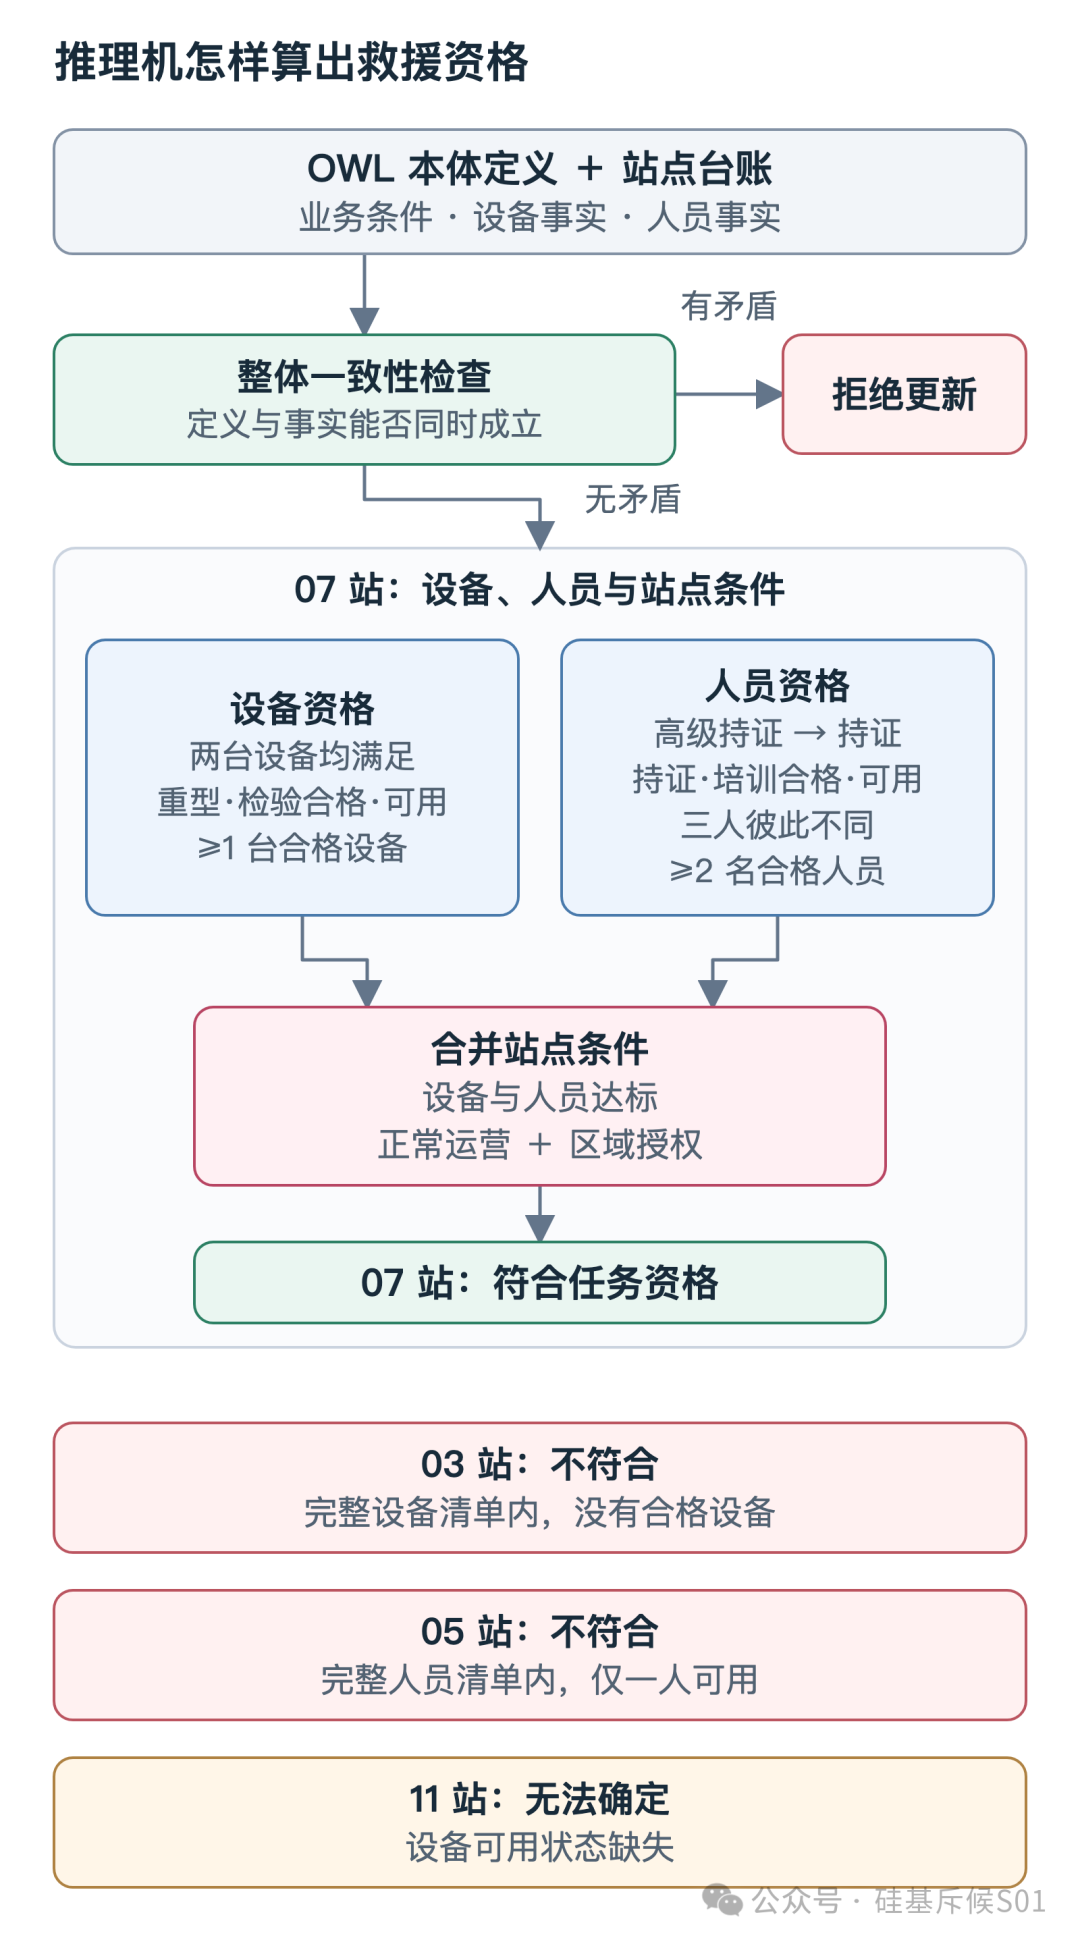
关键在于不把不同对象的条件拼在一起,也不把缺资料当成不合格。03 站的完整设备清单里没有合格设备,可以判不符合;11 站只是缺少设备可用状态,就应保留“无法确定”。
它判断结论的思路,可以理解为“检查反例”:假设 07 站不合格,能否找到一种同时符合全部定义和事实的情形?如果找不到,合格就是必然结论。如果合格与不合格都仍有可能,就保留未知。
四、目前市面上有哪些推理机?
HermiT:牛津大学团队开发,2008 年已有论文。支持复杂 OWL 约束,计算可能较耗资源;我们采用的适配分支主线更新停在 2021 年,需留意兼容性。
ELK:源于乌尔姆与牛津大学,2011 年已有论文。擅长大规模类别分类,但不能处理本文的“至少两人”等数量约束;公开主线最近可见更新在 2024 年。
Openllet:Pellet 的后续分支,主要维护者是 Kévin Séjourné,2016 年已有版本。方便接入 Java 的 OWLAPI、Jena 组件;2025 年仍有代码合并,但稳定版与开发分支进度不同。
RDFox:源于牛津团队,2014 年已有研究成果,现由 Oxford Semantic Technologies 商业化,2026 年仍在更新。适合图数据与规则推导一起使用;需商业授权,也不能等价替代完整 OWL 2 DL 推理。
五、我们怎样把推理机用进本体系统?
在 IndustrialOntology 中,它主要参与两处工作。
**知识生效前检查。**规则和资料先成为候选变更,通过检查才能提交正式版本。实验里,我给 07 站追加了与“正常运营”矛盾的记录,系统拒绝更新,正式版本保持不变。
**计算后供查询复用。**Agent 通过工具读取正式版本的事实、推断类别及依据。设备状态或规则变化后,重新检查、计算并形成新版本。
前面的 32 次对照由脚本固定提供推理结果。另做的两次自主 Agent 查询都未完成,卡在工具预算和对象定位上;这部分还需要改进。
如果本体只用于整理术语,未必需要通用推理器。但对于我想做的系统,**明确的业务规则,应当能够独立执行、检查和复用。**这也是我保留推理机的理由。
规则要写准确,事实要持续更新。把这些积累成可检查的本体资产,带到下一个项目,再让大模型与 Agent 用好它,是我希望继续做下去的方向。
以上就是这次的侦察。
如果对你有用,顺手点个赞 +「♥️」。
想第一时间收到前线情报,关注「硅基斥候S01」。我们,下次侦察见。