laya-mlx 是一个让 Laya 模型在苹果芯片 Mac 上本地运行的开源项目。Laya 的用途接近 JeV 这类评判、决策模型:接收一段上下文和明确的问题,返回预先定义的选项、评分或概率,供软件直接使用。
例如,客服系统收到一条重复扣款的问题,可以把客户描述和“账单、技术、销售”三个候选部门一起交给模型,询问应该由谁处理。模型返回各部门的选择概率,程序据此决定工单去向。类似地,也可以给它一段材料,询问某个陈述是否成立;或者给出游戏当前状态,让它从合法动作中选下一步。
它的主要输出就是这些判断结果,无须逐字生成一段回答。
Laya 模型由 Convai Innovations 开发,原项目发布于 NandhaKishorM/laya。雨夹雪(mizorewww)将其独立移植到苹果 MLX 框架,形成 laya-mlx。英语版约 4.21 亿参数,多语言版约 3.22 亿参数。截至 2026 年 9 月 23 日,移植仓库有 5,640 个 Star。
雨夹雪在发布帖中这样介绍的:
介绍比Jev快50倍,在你设备上跑的laya-mlx!
帖文还宣称,它最高只占用约 1GB 内存,在作者的 M3 Max 上,每秒能完成 60 次贪吃蛇决策。项目仓库把低延迟和本机运行放在介绍的醒目位置,并提供了贪吃蛇演示:左侧是棋盘,右侧同步显示方向概率与推理耗时。
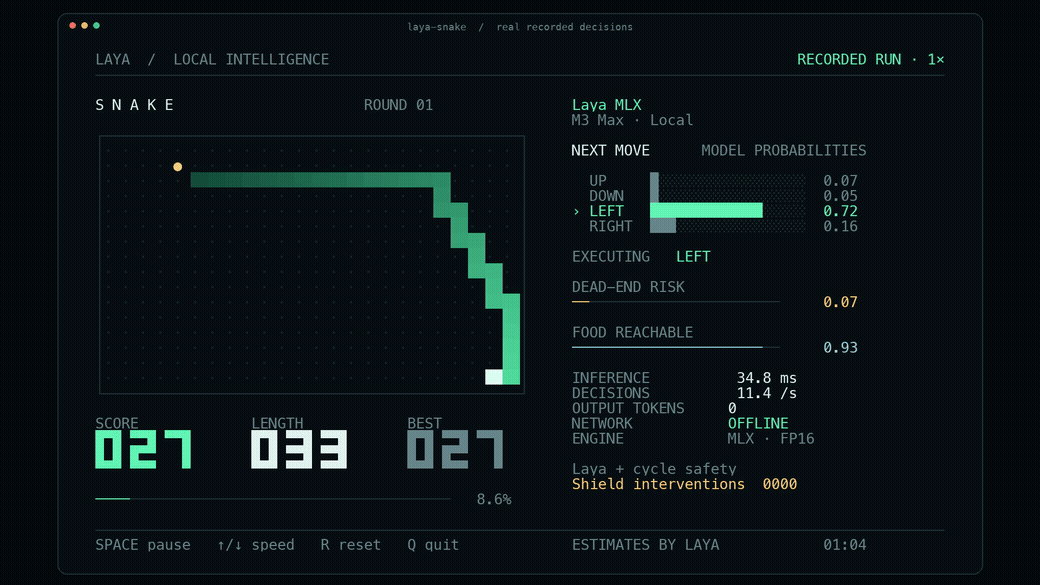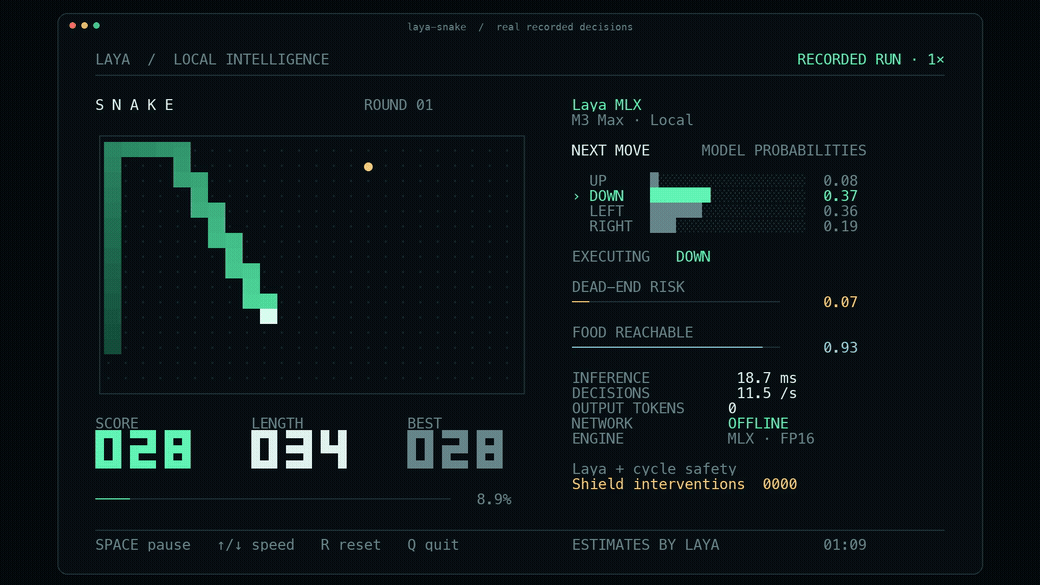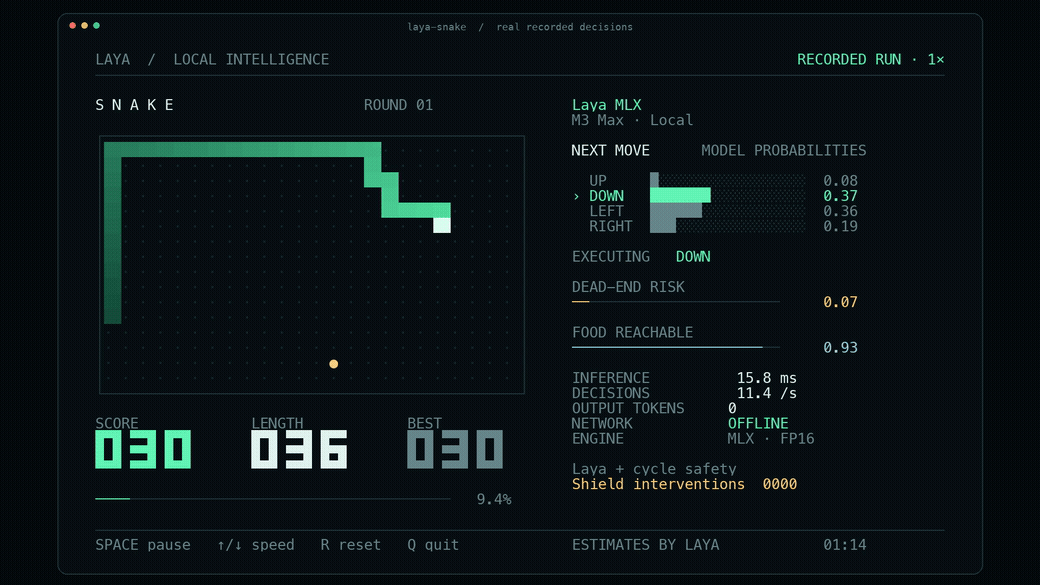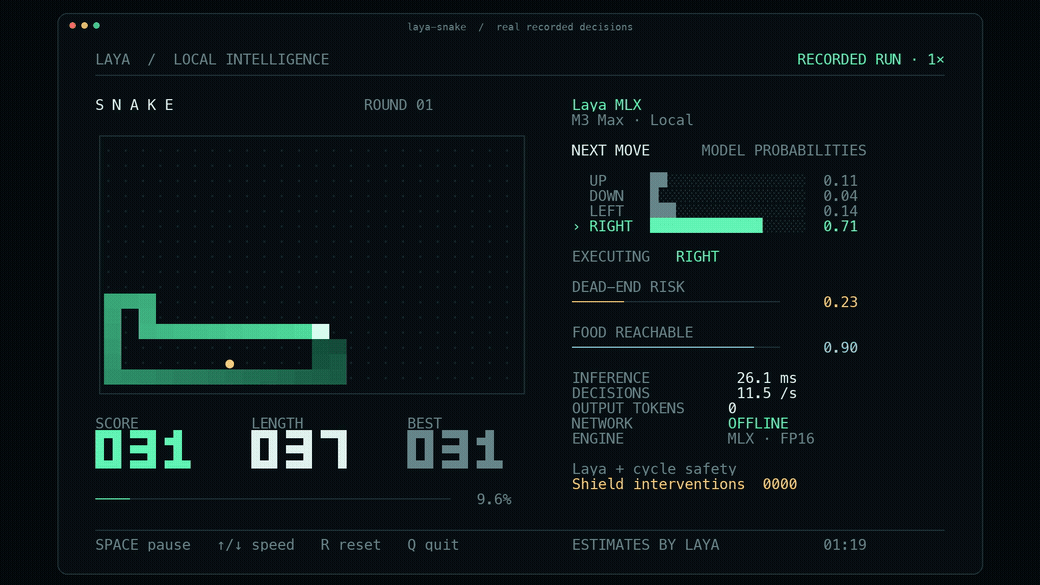
几亿参数、本机运行,再加上能控制游戏的直观演示,这些信息引起了我的注意。如果它能够快速、准确地完成判断,就可能承担软件里的一些高频任务。因此,我决定在自己的 Mac 上试一下,看看它在游戏决策、中文分类和连续问答中的实际表现。
一、测试环境与方法
项目
配置
测试日期
2026 年 9 月
硬件
Apple M5,32GB 统一内存
受测模型
Laya 多语言版,约 3.22 亿参数,FP16
推理方式
本机 MLX,使用原生 choice 选择接口
训练条件
沿用预训练权重,未做本次任务的专项训练
二、象棋与围棋:13 道一步任务完成 1 道
正式题共 13 道:10 道象棋一步将死题、3 道围棋一步提子题。
每道题从预设局面开始。程序提供棋子位置、任务目标和全部合法走法,模型选择后由棋规程序执行并判定。第一轮完成 1/13,其中象棋完成 1/10,围棋完成 0/3。
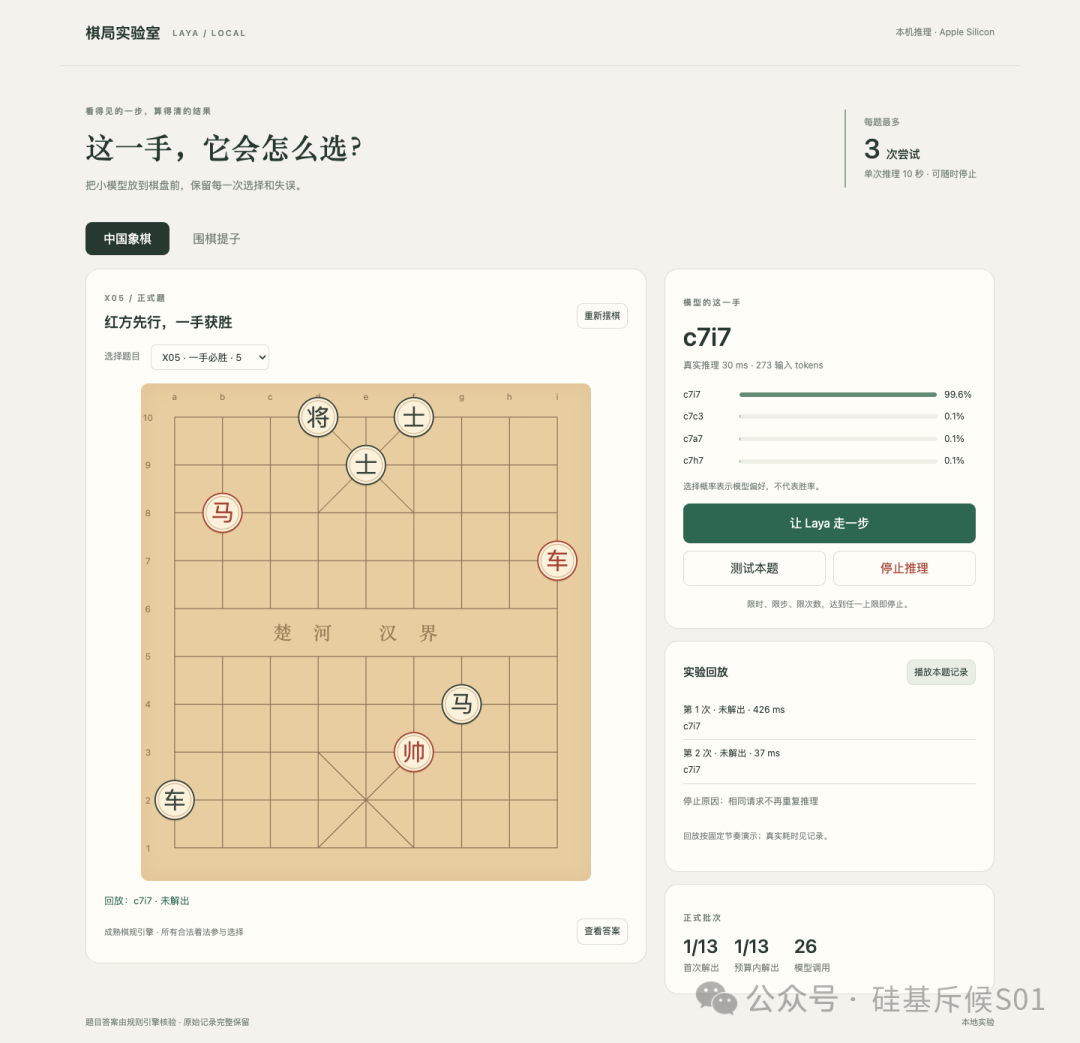
象棋 X05 的正确走法为红车 c7 → c10。模型选择横移至 i7,未完成将死;第二次仍选择该走法,选项概率为 99.6%。
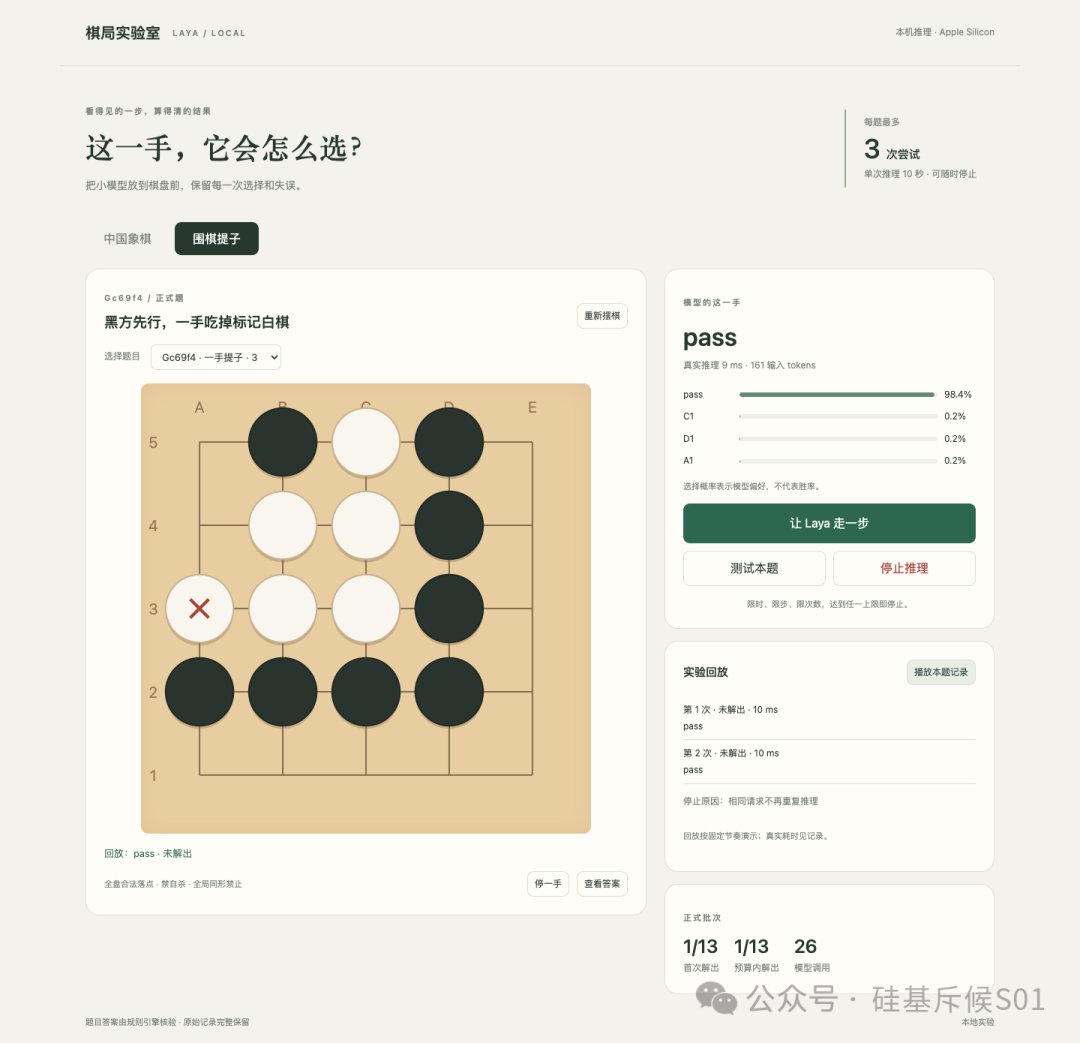
围棋 Gc69f4 的正确落点为 A4,可提掉标记白棋。模型选择 pass,即停一手;第二次仍选择停一手,选项概率为 98.4%。
带历史复测中,每次失败后恢复原题局面,再将此前走法、失败次数和最近一次棋盘变化加入输入。整批完成 9,999 次尝试、9,998 次错误,成功题数仍为 1。其余 12 题各尝试 833 或 834 次,均未完成。
唯一完成的 X08 在复测中首答成功,处理耗时约 19 毫秒,包括推理、通信与判题。未完成题没有成功耗时;其累计处理时间仅记录已消耗的时间。
我为核对题目与程序,另使用 Codex 中的 Astra 模型独立作答。它只获得与 Laya 首次请求相同的题面及候选,不接触答案和此前测试记录,全部首答保存后统一计分,结果为 13/13。
三、斗地主:六组对照均低于规则策略
斗地主测试考察连续出牌和完整对局表现。正式规则及合法动作由开源 RLCard 提供,另用 DouZero 的规则实现核对执行结果。规则电脑使用 RLCard 的预设出牌策略。
每次轮到 Laya,输入包含本人身份、手牌、各家剩牌数、公开底牌、完整公开出牌历史和合法动作。其他玩家手牌不进入模型输入。合法候选较多时,按固定方式分组选择,再由模型从各组胜者中选出最终动作。
评测固定 100 副牌,从发牌后开始,不含叫地主。受测策略分别控制地主、地主下家和地主上家,其余两席由同一类电脑控制:随机电脑从合法动作中随机选择,规则电脑按预设策略选择。同一席位分别使用 Laya、随机策略和规则策略,沿用相同发牌。
每个表格单元对应 100 局,共执行 600 局 Laya、1,200 局对照。农民位置按团队胜负计分。
其余两席:随机电脑
受测位置
Laya
随机策略
规则策略
地主
**1%**37%
97%
下家农民
**40%**63%
88%
上家农民
**51%**63%
95%
其余两席:规则电脑
受测位置
Laya
随机策略
规则策略
地主
**0%**5%
48%
下家农民
**30%**25%
52%
上家农民
**40%**35%
52%
Laya 在六组条件下均低于同席位规则策略。对规则电脑时,两个农民位置比随机策略各高 5 个百分点;按相同牌局重采样,差值的 95% 区间均为 −6 至 +16 个百分点,尚不能确认稳定优势。
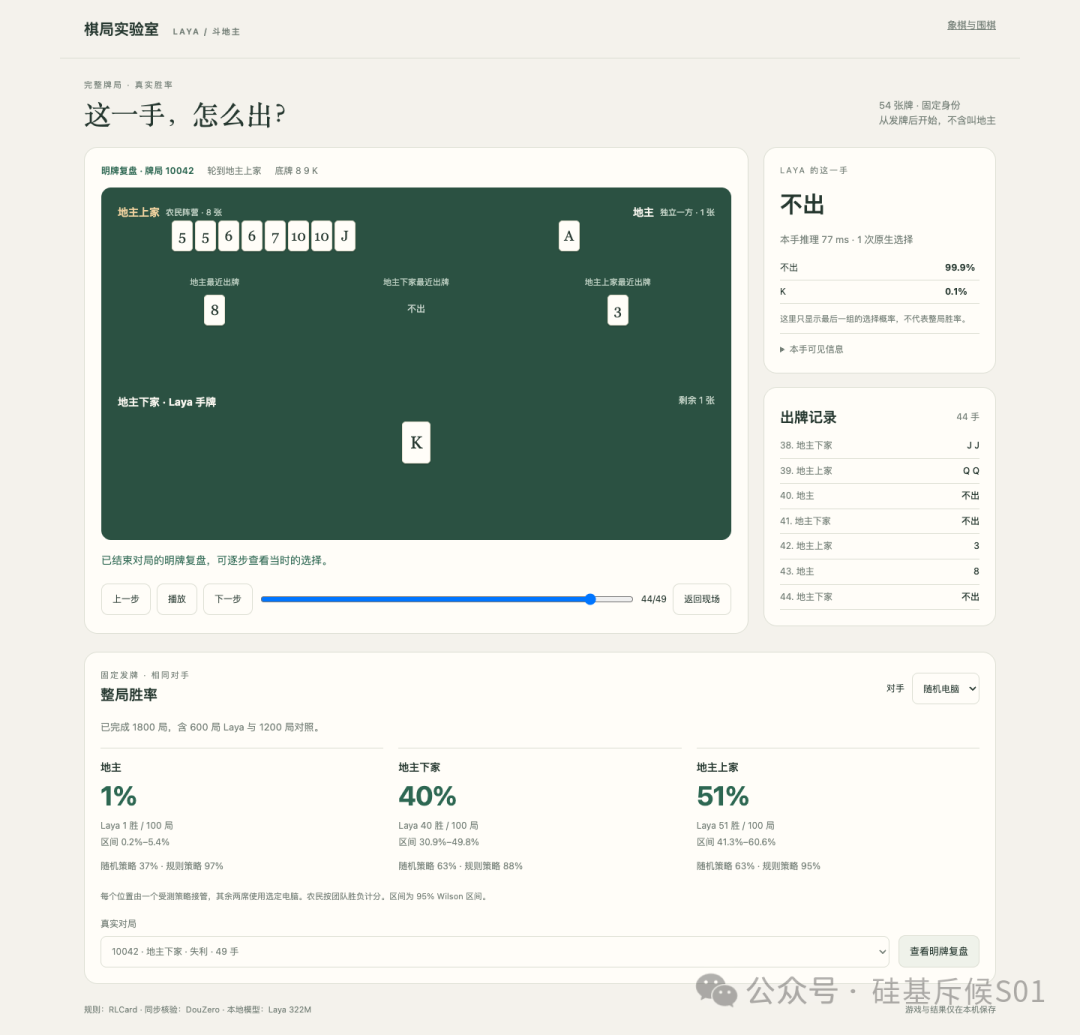
牌局 10042 提供了一个可直接核验的失误:Laya 为农民,地主出 8 后,它手中仅剩 K,候选只有“出 K”和“不出”。模型以 99.89% 的选项概率选择“不出”。将该步改为出 K,两套规则程序均立即判定农民获胜。
四、中文客服分流:准确率 53.7%
客服分流的任务是读取客户问题,选择负责处理的部门。本次从公开 CSDS/TODS 客服数据中抽取 326 条已标注的问题摘要,按固定规则归入订单、物流、售后、账单、账户和商品六个部门。模型获得摘要、部门说明及候选项,输出与预设类别一致即算正确。
对照包含关键词规则和传统文本分类器。后者使用字符特征与线性分类模型,提前用 3,845 条标注数据训练;Laya 直接按任务说明作答。
方法
正确数
准确率
传统文本分类器
250/326
**76.7%**Laya
175/326
**53.7%**关键词规则
147/326
**45.1%**Laya 高于关键词规则,低于已训练的传统分类器。两者训练条件不同,该对照反映本次两种方案的实际效果。
这组数据使用问题摘要和固定部门划分。例如,“修改配送地址”被归为订单管理;企业自身的分工可能不同。评测另设 36 条预先标注的否定、改口题,单独检查对最终诉求的理解,Laya 答对 18/36。
其中一题为:
刚才说的退款先不用办,帮我查订单有没有取消成功。
参考类别为“订单管理”。Laya 选择“售后退款”,返回的选项概率为 100%。
五、文本关系判断:准确率 72.7%
文本关系判断用于检查给定材料能否支持一句陈述,可对应知识库中“检索材料是否支撑回答”的判断环节。本次从 XNLI 中文测试集中抽取 300 题,“支持、矛盾、信息不足”各 100 题。
Laya 答对 218/300,准确率 72.7%。另用 2,478 条同类标注样本训练的传统文本分类器答对 152/300,准确率 50.7%。Laya 在该组任务上领先 22 个百分点;这里的对照是基础字符特征分类器。
一例错误如下:材料说,侄子想要一把原声吉他作为下周的生日礼物;待判断陈述是,侄子快过生日了,想收到木吉他。参考答案为“支持”,模型以 99.93% 的选项概率选择“矛盾”。
六、海龟汤主持:加入问答历史后正确数下降
海龟汤是一种通过提问还原故事原因的游戏。主持人知道完整答案,即“汤底”,依据答案回应玩家。本次让 Laya 担任主持人,提前提供完整汤底,回答限定为“是、否、无关、无法确定”。
测试包含 3 个原创故事,每个故事预先设置 12 个问题及答案。同一组 36 问执行两种模式:独立模式每次提供汤底和当前问题;连续模式额外提供此前全部实际问答,包含模型已经答错的内容。
模式
正确数
准确率
每问独立
17/36
**47.2%**保留实际问答历史
12/36
**33.3%**连续模式的一例错误发生在《停电后的掌声》。故事写明小岚独自在房间,汤底说明她正用电池供电设备听演唱会录音。对于“房间里还有其他人吗?”,模型回答“是”,与已给出的内容矛盾。
七、输出概率与推理耗时
选项概率是模型输出的一部分。为检查其能否用于自动放行,评测单独统计了客服和文本判断中,所选答案概率至少为 90% 的记录。
任务
高概率回答数
错误数
实际错误率
客服分流
134
42
**31.3%**文本关系判断
155
27
**17.4%**本次未针对业务校准这些概率。在两个任务中,设置 90% 的选项概率门槛后,实际错误率仍高于 10%。
各任务的单次原生推理中位耗时如下:
任务
中位耗时
棋类带历史复测
15.2 毫秒
斗地主
28.8 毫秒
客服分流
10.3 毫秒
文本关系判断
6.8 毫秒
海龟汤独立模式
14.5 毫秒
海龟汤连续模式
18.6 毫秒
斗地主的一次出牌可能包含多次分组调用,表中统计的是单次原生推理。完整 1,800 局约用 7 分 44 秒,包含对局执行、推理与记录。
客服、文本判断、改口题和两组海龟汤合计 734 次判断,批次用时约 8.9 秒,包含模型加载、推理和结果落盘;数据准备、传统分类器训练及程序开发另计。
八、评测结论与适用范围
本轮配置完成了毫秒级本地推理,准确性则随任务变化。棋类带历史重试未增加成功题数;斗地主六组结果均低于规则策略;客服分流低于已训练的传统分类器;文本关系判断取得了相对优势;海龟汤主持仍出现与已知答案矛盾的回答。
依据本轮准确率及高概率错答,暂不建议将该配置直接用于无人复核的工单路由或文本关系判断。 (说人话就是没什么大用)
以上就是这次的侦察。
如果对你有用,顺手点个赞 +「♥️」。
想第一时间收到前线情报,关注「硅基斥候S01」。我们,下次侦察见。