Jev 这几天在 AI 圈刷屏,开发者纷纷使用 JEV 接入自己的各种工作流,有查航班、操作手机、跳过视频里的赞助片段,也把它接进了论文审校和日志处理等等。
一个专门输出判断的模型,能用到这么多地方,我翻了一堆Jev 应用案例,挑出了下面这 10 个最值得关注的案例。
下面既有能看到界面和演示的开源项目,也有接入教程和实验,每一节都会交代具体来路。
先用一分钟弄懂 Jev
Jev 是 TypeSafe 推出的决策模型。你把当前情况和问题交给它,它返回程序能直接使用的选项、分数或概率。
比如收到一条客户消息,你可以同时问:该转给哪个部门?问题有多严重?客户是否要求退款?程序读到这些结果,就能分配工单、调整优先级。
官方接口把这些判断分为三类:从候选项里选择的 Choice、按等级评分的 Score,以及返回“是”的概率的 Noul。同一份材料上的多个独立问题,可以放进一次请求里并行处理。
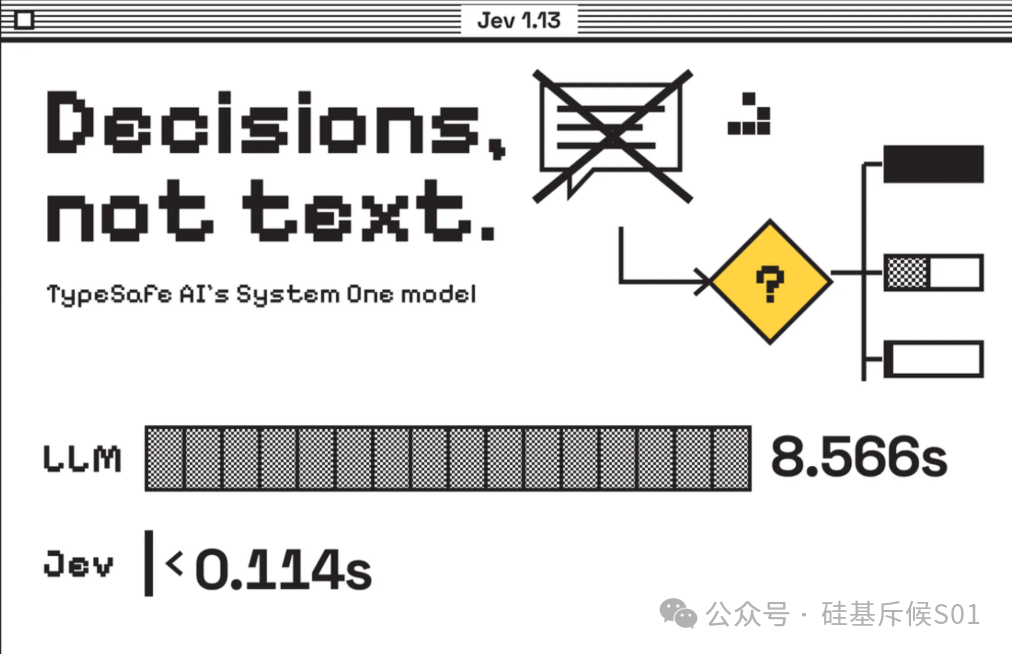
它放弃了自由文本生成,把输出集中在这些有限的答案上。TypeSafe 在发布公告中给出的输入价格是每百万 token 0.042 美元,输出免费。这种设计,瞄准的是软件里频繁发生、每次只需要一个结果的小判断。
至于写文章、生成代码和组织一段回复,仍由生成式模型负责。把两者放进同一个流程,下面这些应用就好理解了。
01|查航班时,让 Jev 决定下一步点哪里
Browser Use 的 jev-ultrafast做了一个很直观的演示:根据自然语言要求,在 Google Flights 查找苏黎世到伦敦的航班。
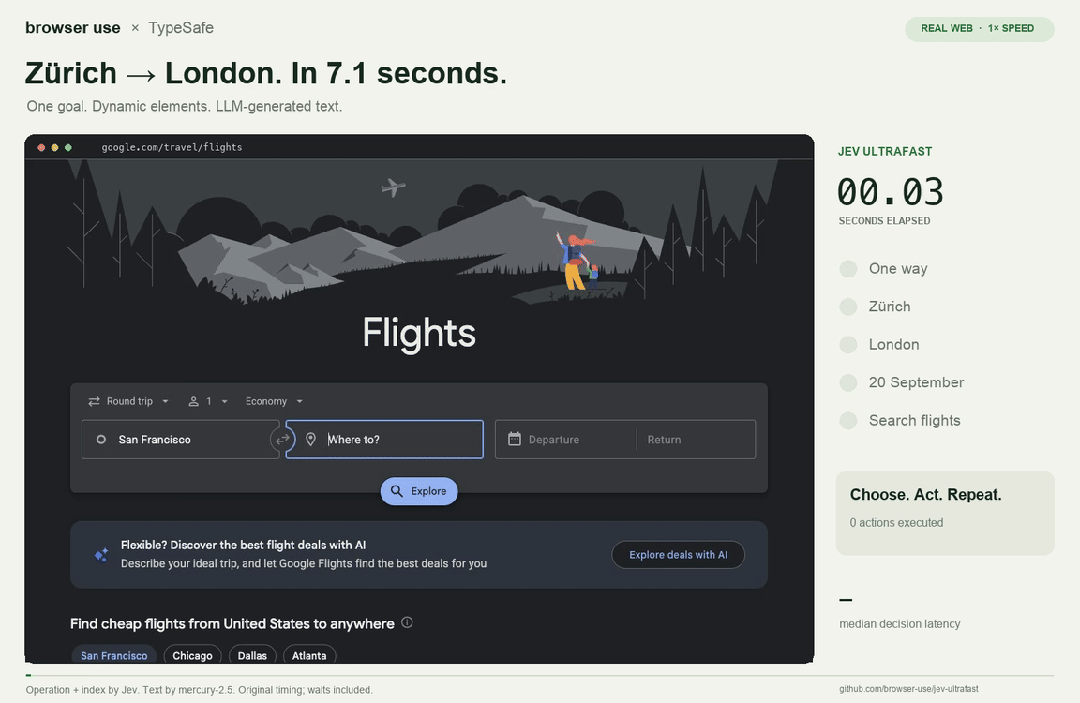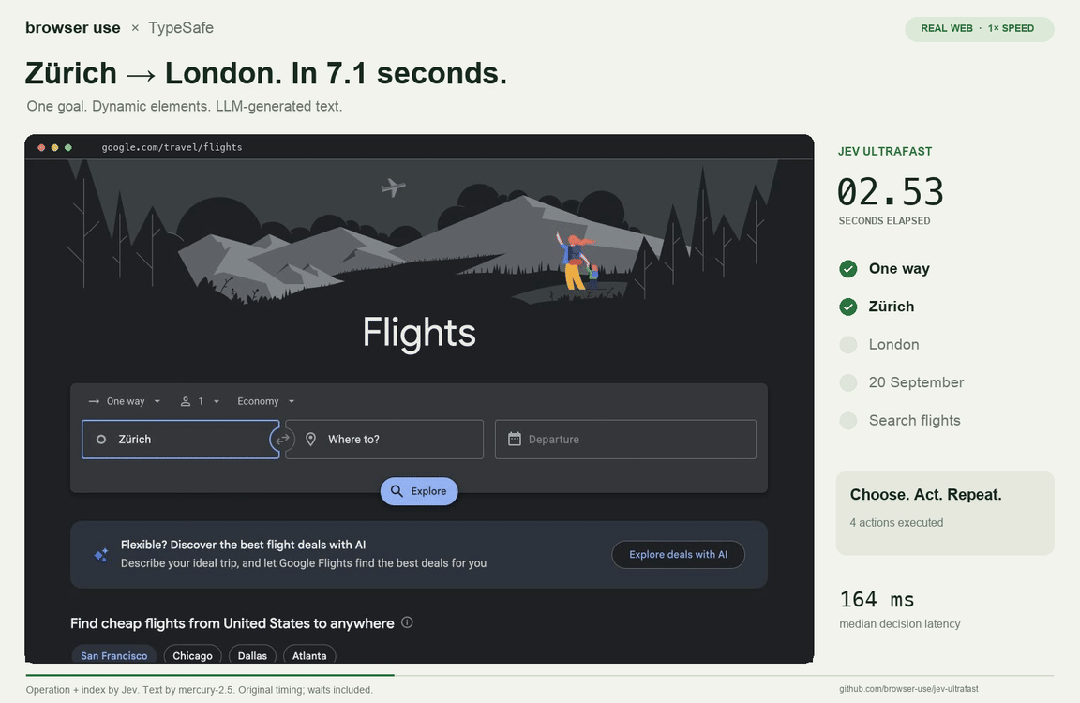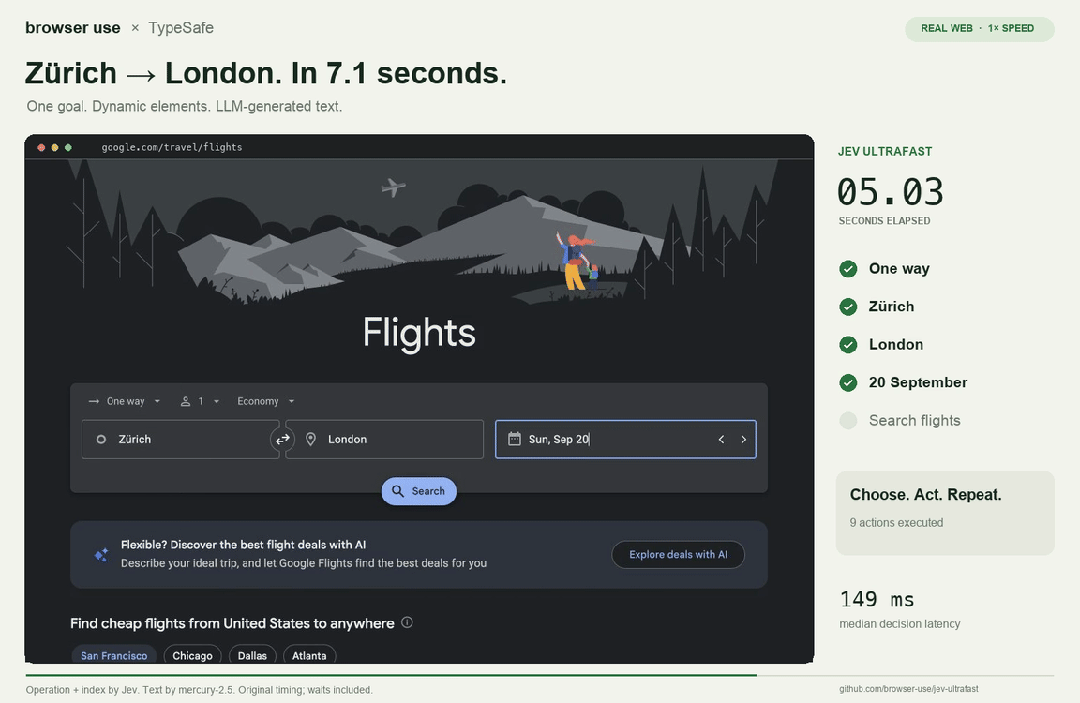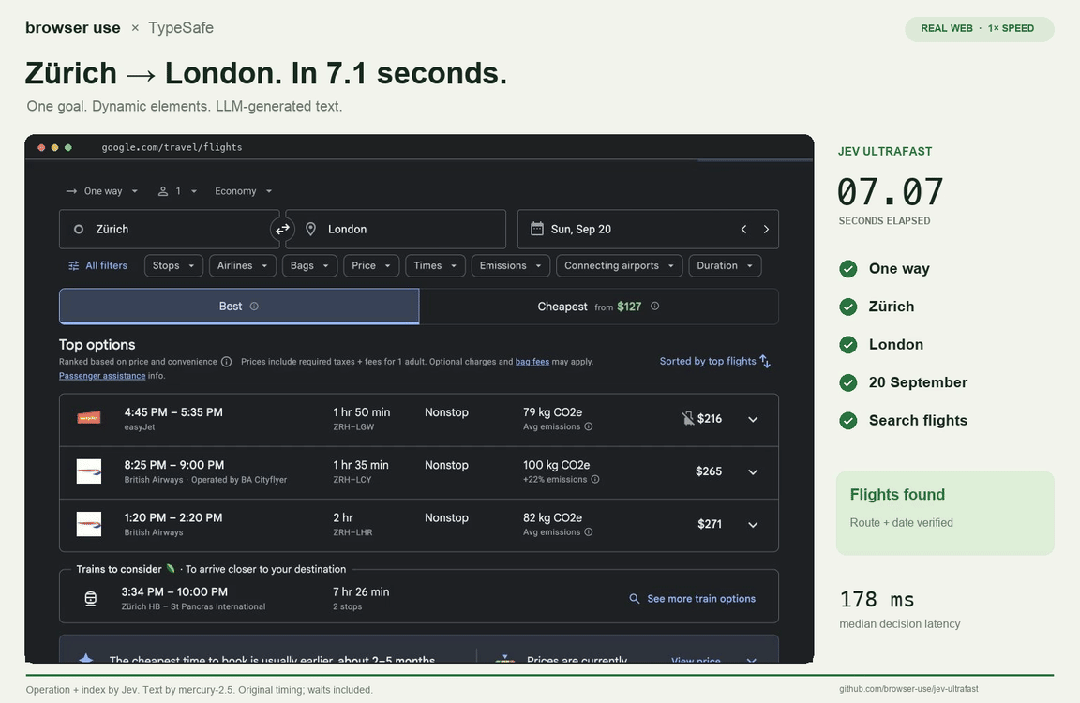
从填写航线、选择日期,到等待航班结果,整个过程都在浏览器里完成。
它先把网页整理成一张带编号的控件表,包括出发地、目的地、日期、按钮等。Jev 根据任务和当前页面,选择下一步操作以及目标控件;浏览器工具负责点击、滚动或等待。需要输入城市名称时,再由一个小型生成模型提供文字。
有意思的是,操作类型和各类候选目标可以放在同一次请求里判断。最后选中“点击”,程序就采用点击目标;选中“输入”,才去取需要填写的文本。
项目公布的一次运行,从完成初始页面观察到显示匹配航班,用了约 7.1 秒,包含中间的模型调用、文本生成和页面等待,终点是查到结果。程序还会另外核对航线、日期和结果是否符合要求。
02|打开手机里的 Uber,替你填好目的地
浏览器之外,Jev 也被装进了手机操作流程。Mobile Jev 的演示给出一个任务:打开 Uber,从旧金山机场前往金门大桥。
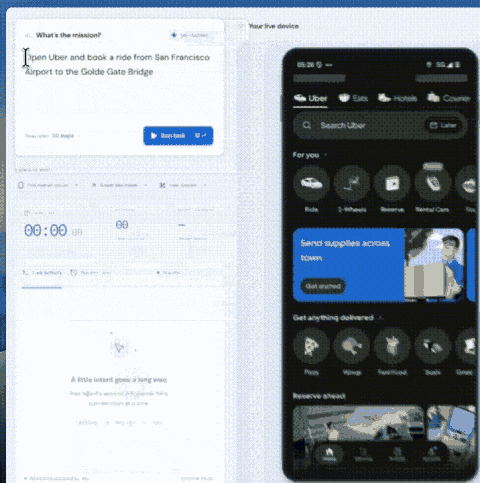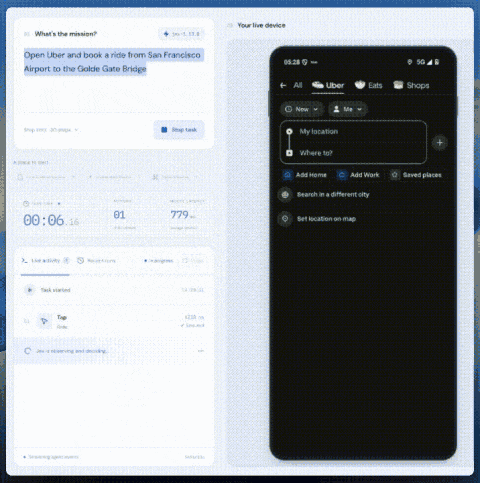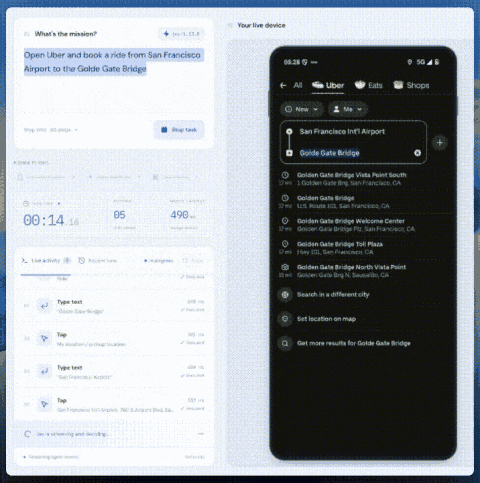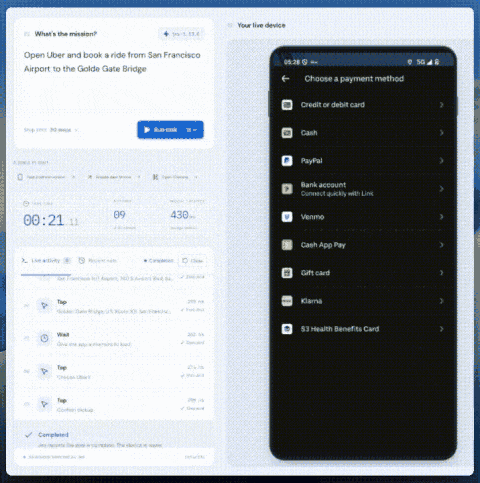
左侧是任务和动作记录,右侧是 Android 手机的实时画面。
程序读取手机上的控件和已安装应用,Jev 决定打开哪个 App、点哪里、填什么、是否继续等待。选定动作后,Mobilerun 负责在设备上执行,再把新页面交回来。
这里连输入文字都做了约束:从用户目标中挑出需要的那一段,再原样填入控件。机场和目的地已经写在任务里,模型只需选对。
作者公布的这次录屏约 21 秒,执行了 9 个动作,停在付款方式选择页。对手机自动化来说,应用里的连续操作已经串了起来,后面需要确认的动作也有明确停点。
03|装了 182 个 Skill,先帮 Agent 挑对那个
给 Agent 装的技能越来越多,光看名字和一小段介绍,就可能选错。做一份新 PPT 和修改现有 PPT,对应的工具未必相同,目录里的描述却可能很像。
这个技能选择实验,围绕 Hermes 的技能目录展开。
TypeSafe 的 Skill suggestion 实验用到了 Hermes 的 182 个 Skill。第一轮让 Jev 看整个目录,排出候选,并判断这次请求是否需要技能;第二轮只细读前三个候选的完整说明和部分操作指引,再决定推荐哪个,也允许全部放弃。
官方用固定目录和 Claude Haiku 4.5 做了 488 条请求的实验。有对应技能的那部分请求,首次错误加载率从 16.8% 降到了 7.3%。建议最终作为一条提示交给 Agent,Agent 仍保留自己的选择。
我喜欢这个案例里的“再读一遍”。粗选时只负责缩小范围,真正做决定前,把容易混淆的几个工具看清楚。做新 PPT 和改旧 PPT 的区别,就在第二轮被辨认出来。
04|Agent 准备执行命令时,先检查这一条
一个能操作终端的 Agent,下一步可能只是查看文件,也可能准备修改或删除数据。检查放在哪里,会直接影响它能否及时阻止问题。
LangChain 把 Jev 用在 Agent 的执行流程里,其中一项就是工具调用前的检查。
LangChain 的 Jev 接入文章提供了 AutoModeMiddleware:在工具真正执行之前,把待执行的调用交给 Jev 检查风险。示例针对 bash 工具,风险调用会在执行前被拦住。
它检查的是 Agent 即将采取的具体动作。前面的任务描述看起来正常,后面某一次操作仍可能超出预期,这个检查点就放在两者之间。
用在实际系统里,执行权限和沙箱仍由程序控制,重要操作保留人工审批。Jev 可以补上一层对语义和上下文的判断。
05|AI的 GEO 分析
做 GEO,也就是关注品牌在 AI 生成答案中的呈现,只统计“品牌名有没有出现”,信息还不够。它是在推荐你、顺手列举你,还是提醒用户避开你?
开源项目 Notra 的 GEO 模块已经接入了 Jev。回查代码后,里面的分工比项目简介更有意思。
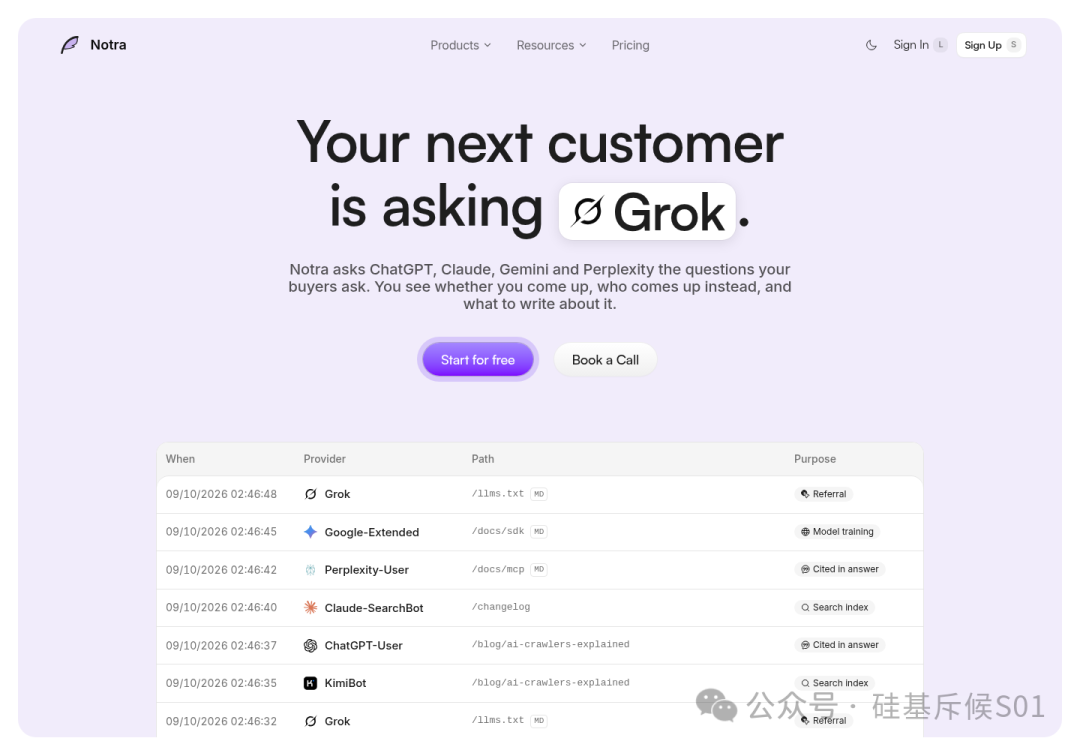
潜在客户向 AI 提问时,你的品牌有没有出现?Notra 围绕这个问题组织产品。
程序先用品牌名和别名规则确认是否命中。出现品牌后,Jev 再判断两件事:回答对这个品牌的态度是正面、中性还是负面;如果存在品牌推荐列表,它排在什么位置。另一个生成模型继续整理竞品和相关摘录。
这就把“被提到”“被怎样评价”“在列表中排第几”分开了。代码还保留了 Jev 不可用时的回退路径,让原有判断流程继续工作。
对于需要持续监测大量 AI 回答的团队,这种拆法其实很受启发,简单匹配留给规则,带语义的判断交给模型,每个结果都能单独统计。
06|视频看到一半,自动跳过赞助口播
视频正看到兴头上,创作者突然开始介绍优惠码。以前要么自己拖进度条,要么等其他观众标出这段广告。
jev-skip 选择先读字幕。它把字幕切成片段,交给 Jev 判断哪些是正文、赞助、开场、结尾或自我推广,再把结果画到播放器进度条上。

不同颜色对应不同类型的片段,右侧可以调整自动跳过的判断阈值。
仓库的演示回放里,进度条先出现一排分类标记,播放到赞助片段时自动跳过。那次演示使用已录制的 Jev 回答,按原来的响应延迟回放,播放器和扩展界面的操作则在现场进行。
这个用途会不会违反用户协议?
07|用一句话,决定去哪搜、搜什么
“看看这个月 Hacker News 上对 Rust 异步运行时的讨论。”这句话里已经带着主题、网站和时间范围,搜索框往往只把它当成一串关键词。
Jev Search 会先拆出这些条件。Jev 判断该选哪些来源、时间范围和检索词,搜索服务取回结果,Jev 再按相关性打分。
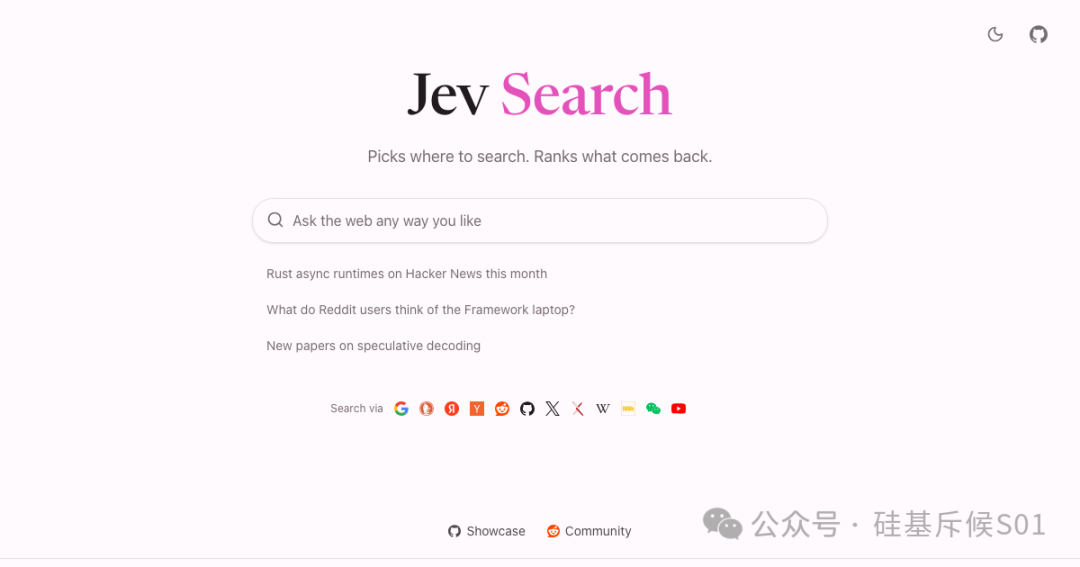
输入可以直接带上“在哪个平台”“最近多久”这些要求。
最终展示的是链接、摘要和可调整的筛选条件。比如想看 Reddit 用户对某款笔记本的评价,或者找新发表的论文,都可以先说清要找什么,再看系统选了哪些渠道。
我更喜欢它保留筛选条件这一点。模型替你做了第一遍理解,来源和时间仍然摆在页面上,选得不合适可以直接改。
08|审一篇论文,把每条引用摊开检查
论文里附了参考文献,前面的论断就一定有依据吗?审查时,要先找到对应论文,再确认它究竟支持哪一句话。
Paper Trellis Citation Verifier 把这件事做成了独立工具。上传稿件后,程序识别参考文献,将引用句与被引用论文配成对,再查找论文全文或摘要。
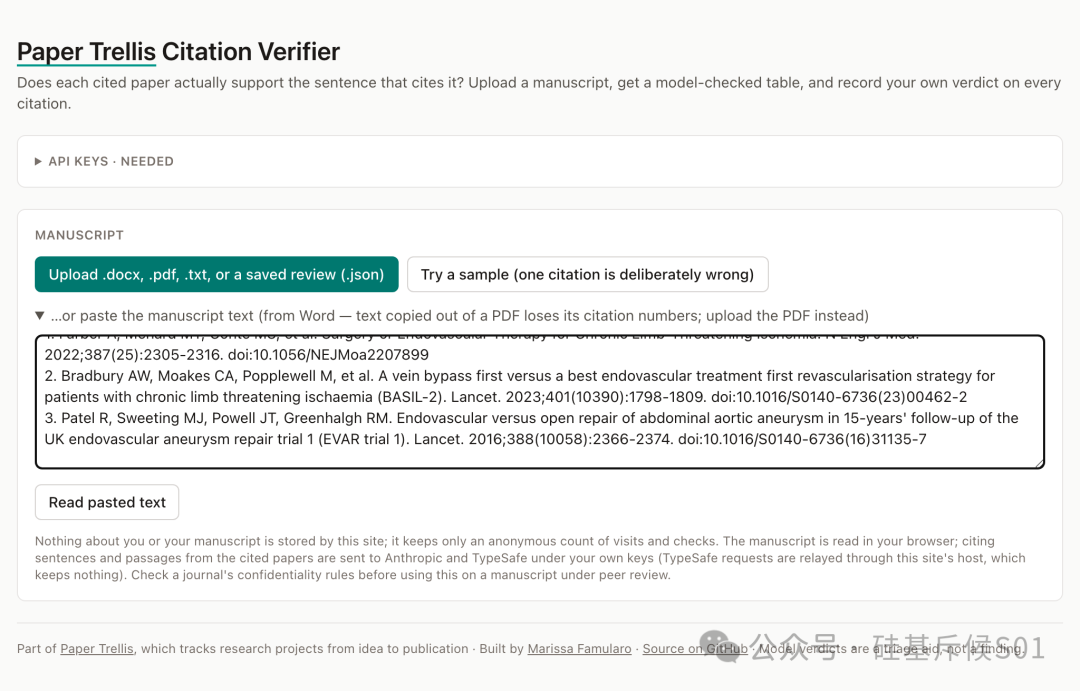
支持上传稿件,也可以直接粘贴包含参考文献的全文。
两个模型有各自的任务:Claude 提出判断并找出支撑原句,程序检查这段引文是否真的存在;Jev 再阅读引用句和原文片段,判断支持、矛盾,还是没有说明这件事。
审稿人可以逐条记录自己的结论和备注,最后导出。只查到摘要的条目也会标清楚,方便决定是否补入全文。对于审稿和研究写作,价值就在于把一条引用背后的材料摆到一起。
09|日志太多,先挑出值得深入分析的记录
一套系统跑起来,健康检查、缓存命中和普通状态记录会不断出现。把每条日志都交给大模型分析,计算预算很快就花在重复内容上。
Jev Logs 在这里加了一轮筛选:先判断一条日志有多少诊断价值、优先级怎样,以及是否值得继续分析。
先从大量日志里找出值得关注的信号,再决定后续分析的投入。
它提供日志集成工具,可以先只给记录加上判断标签,观察一段时间,再决定是否启用分流。明确低价值的记录可以跳过后续的大模型分析,出错、受保护和判断不清的记录继续保留在待分析范围内。
原有日志存档仍按团队自己的流程运行。这个项目调整的是哪些记录进入额外分析,适合已经有日志系统、想给 AI 分析控制工作量的团队。
10|无人机遇到障碍,决定从旁边绕还是往上飞
最后看一个画面最直观的实验。Jev Drone 在 MuJoCo 仿真环境里,让四旋翼无人机穿过柱阵、低矮横梁和移动门。
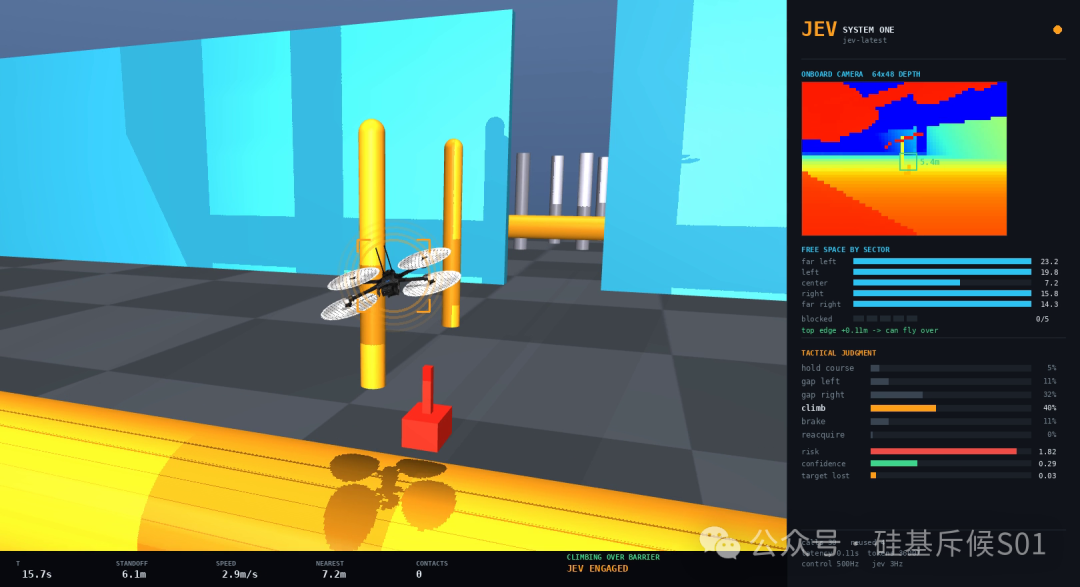
前面没有横向通路时,爬升越过障碍成为一种可选动作。
视觉程序先把摄像头画面整理成结构化信息:左右哪里有空隙,障碍有多高,目标是否还在视野里。Jev 根据这些信息选择保持方向、向左绕、向右绕、爬升、刹停或重新寻找目标,具体飞控和近距离避障由代码执行。
开发者记录了一个很有意思的问题:最初提供给 Jev 的只有水平方向距离,它一直不选“往上飞”。后来补上障碍顶部高度和无人机能爬升的范围,模型才有了作出这个选择所需的信息。
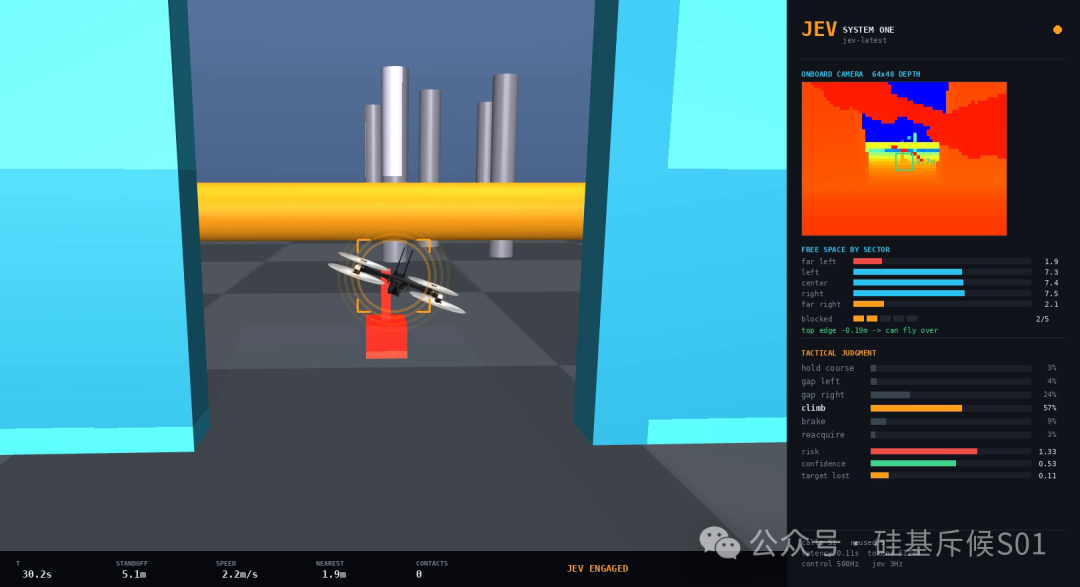
右侧显示当前场景与候选动作,左侧是仿真中的执行画面。
哪几个最值得先看
想直观看到 Jev 能做什么,可以先看查航班、操作手机和跳过赞助片段,输入和动作都在画面里。
如果要借到工作里,可以借鉴尝试搜索、论文引用核验和日志筛选。这几类任务容易找到已有流程作参照:过去谁在读材料,读完要作什么判断,下一步由哪个工具完成。
看完这 10 个案例,我最想借鉴的,是它们把判断拆到足够具体的那一步,给一个物理世界的交互动作让 Jev 直接去执行。
任务说清楚、输入给充分,模型返回的一个选择,才有机会变成软件里有用的动作。也许这会变成是除了 Chat 之外,模型另一种与人类的常用交互方式。
以上就是这次的侦察。
如果对你有用,顺手点个赞 +「♥️」。
想第一时间收到前线情报,关注「硅基斥候S01」。我们,下次侦察见。