腾讯开源的 T-Mem,能帮 AI 做什么?
腾讯开源了一套叫 T-Mem 的长期记忆系统。它主要能给你的 agent 记忆能力,你过去说过的事,到了该用的时候,它能自己想起来。
该项目已经公开代码和配套论文。开发者可以借助这套记忆机制,让对话助手更好地利用过去的交流。
论文用过一个很容易理解的场景:之前聊天时提到,同事海鲜过敏。过了一段时间,用户问的是“团建去哪吃”。
一个能用好记忆的助手,这时就应该把那位同事的情况考虑进去,选餐厅时避开不合适的选项。用户不用再把过敏的事重复一遍。
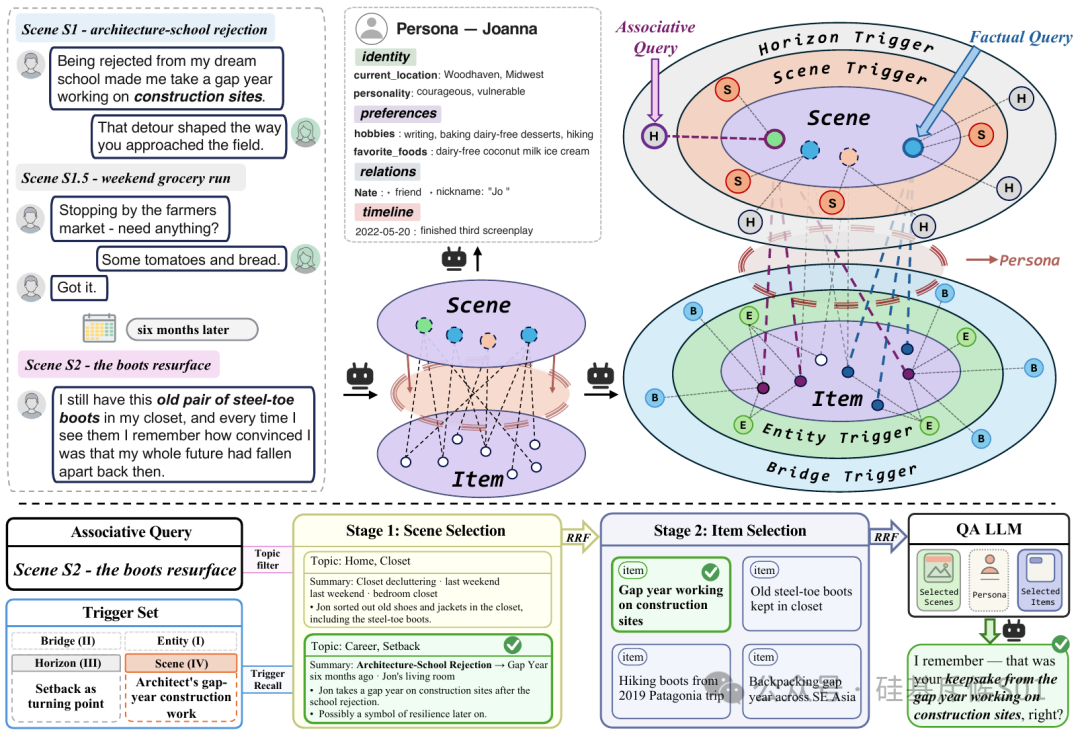
T-Mem 的主要亮点就在这里:保存一件事时,顺手想一想,它以后可能在哪些场合派上用场。 “海鲜过敏”便可以提前与“聚餐选餐厅”关联起来。等到新问题出现,系统多了一条找回旧信息的路。
放到工作里,这种能力很实用。客户以前交代的部署限制,后来写方案时要遵守;项目中曾经踩过的坑,下次安排同类工作时要考虑。旧信息能参与新判断,助手才能少让人反复叮嘱。
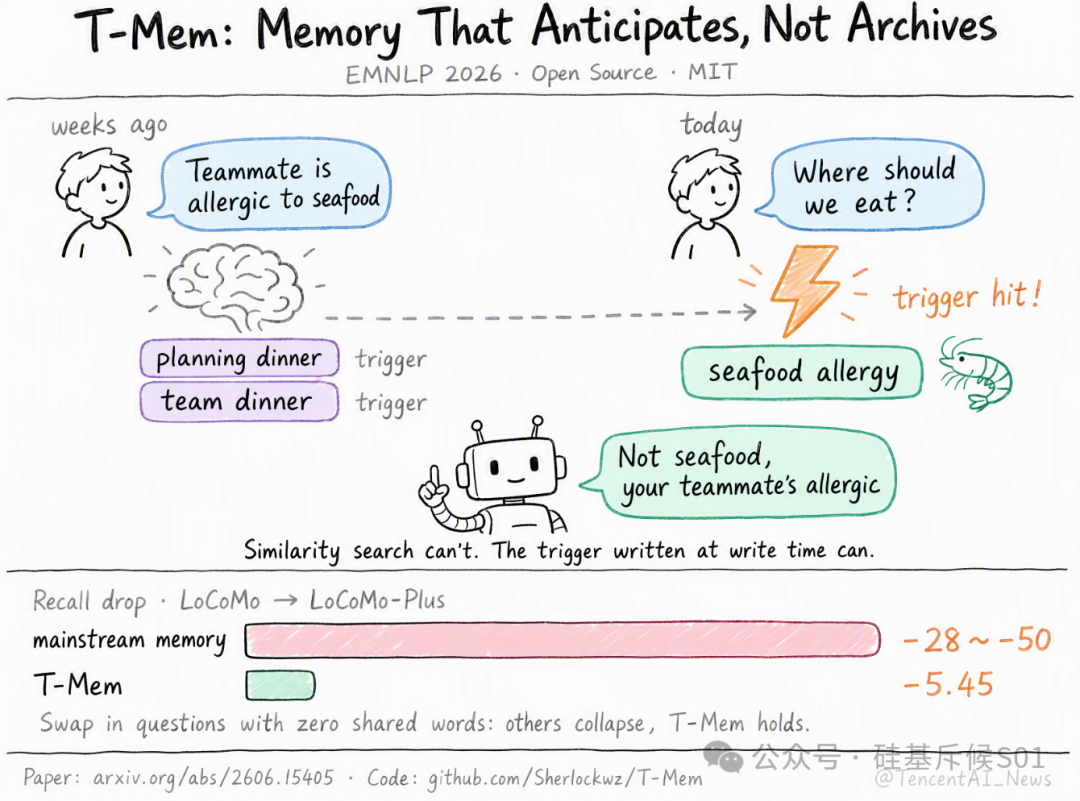
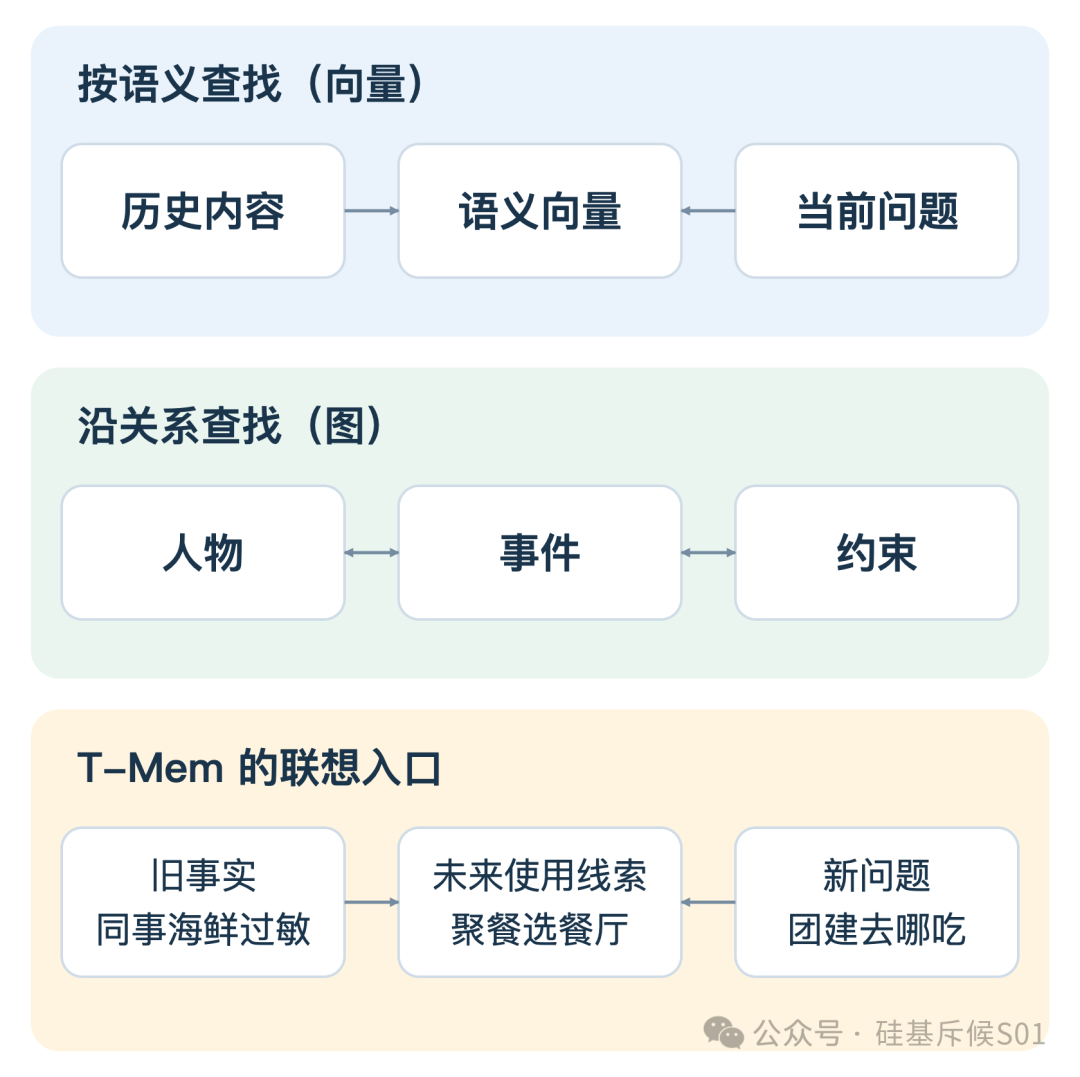
这与常见的 AI 记忆有什么区别?常见的 AI 记忆检索形式主要是以下两种:
按语义查找,也就是向量检索。 它把文字转换成一组表示语义的数字,再寻找与当前问题语义相近的内容。
沿关系查找,也就是图结构。 它将人物、项目、约束等连起来,查一个客户时,可以继续找到对应项目和部署条件。
T-Mem 在向量和结构化关系的基础上,增加了按使用场景联想的办法。回到前面的例子,系统会先把“同事海鲜过敏”这条旧事实,与“聚餐选餐厅”这个未来使用场景连起来。
等到你问“团建去哪吃”,就可以先匹配“聚餐选餐厅”这条线索,再顺着它找回过敏信息。图里的“联想入口”,指的就是这些预先留下的使用线索。
它的记忆形成方式
用一个工作例子说明。你在沟通中告诉助手:“这个客户的生产环境不能联网。”这段话经过 T-Mem 整理,会留下几种互相关联的内容。
它先按事情把对话分成场景。一场交流可能谈了部署、费用和排期,系统会尝试分开整理;一件事也可能经过好几轮问答才说完,因此场景不必等同于某一句话或一轮聊天。
在部署这个场景里,原话和事情的简要经过会被保留下来。系统再抽出具体事实,例如“客户生产环境不能联网”,并用“客户部署条件”这样的主题把相关内容归到一起。
这样,需要看前因后果时,有整段场景可查;只需要那条限制时,可以直接取出事实。
接下来是 T-Mem 着重增加的一步:为旧信息补上未来可能的用法。简单来说就是让大模型再做一遍联想,沿着这个方向,可以想到写部署方案、准备离线安装包、安排后续升级。这些事以后都可能碰到联网限制。
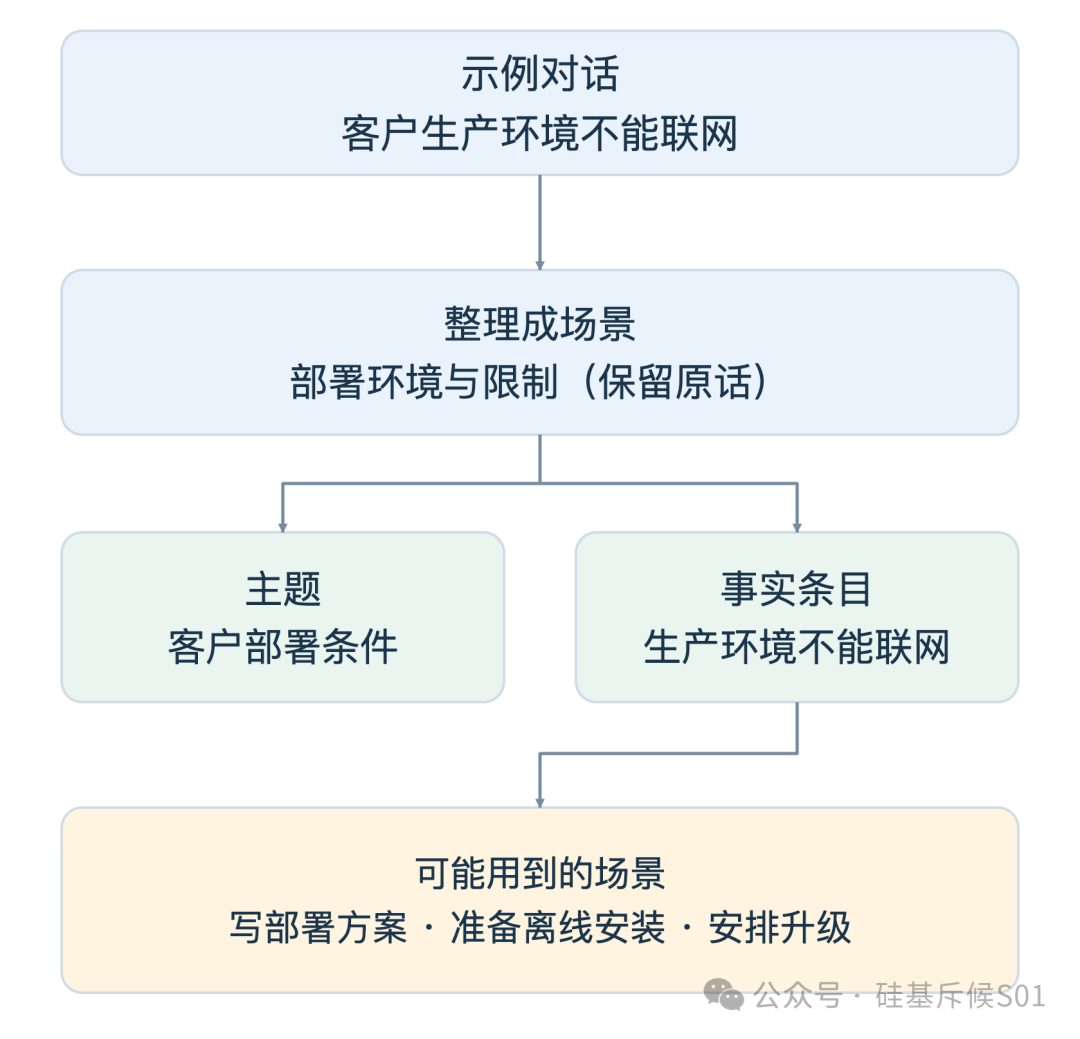
图里的业务内容用于说明原理。它既会给单条事实补充概念和使用场合,也会从整段经历中寻找后续目标、选择或回避行为的线索。
整理之后,系统保留了过去发生的事,也保存了以后查找它的线索。线索与相关事实、场景之间都有联系,找到其中一项,可以继续取回对应内容。
它的记忆检索方式
假设几周后,你只说:“帮我写这个客户的部署方案。”
系统会寻找与问题相关的历史内容,也会检查以前准备的使用线索。如果“写部署方案”匹配上了某条线索,就有机会把“生产环境不能联网”这条旧限制带回来。
这就是代码里“联想”的具体做法:保存时先把可能的联系写出来,使用时沿着联系找旧信息。读取阶段依然会计算内容有多相关,只是能够比较的文字更多了。
找到的材料还要再筛选。T-Mem 会将不同途径找到的候选放到一起,优先保留更相关的部分,再交给回答问题的模型。这个例子中,助手拿到联网限制后,写方案时就有了安排离线安装、准备依赖包的依据。
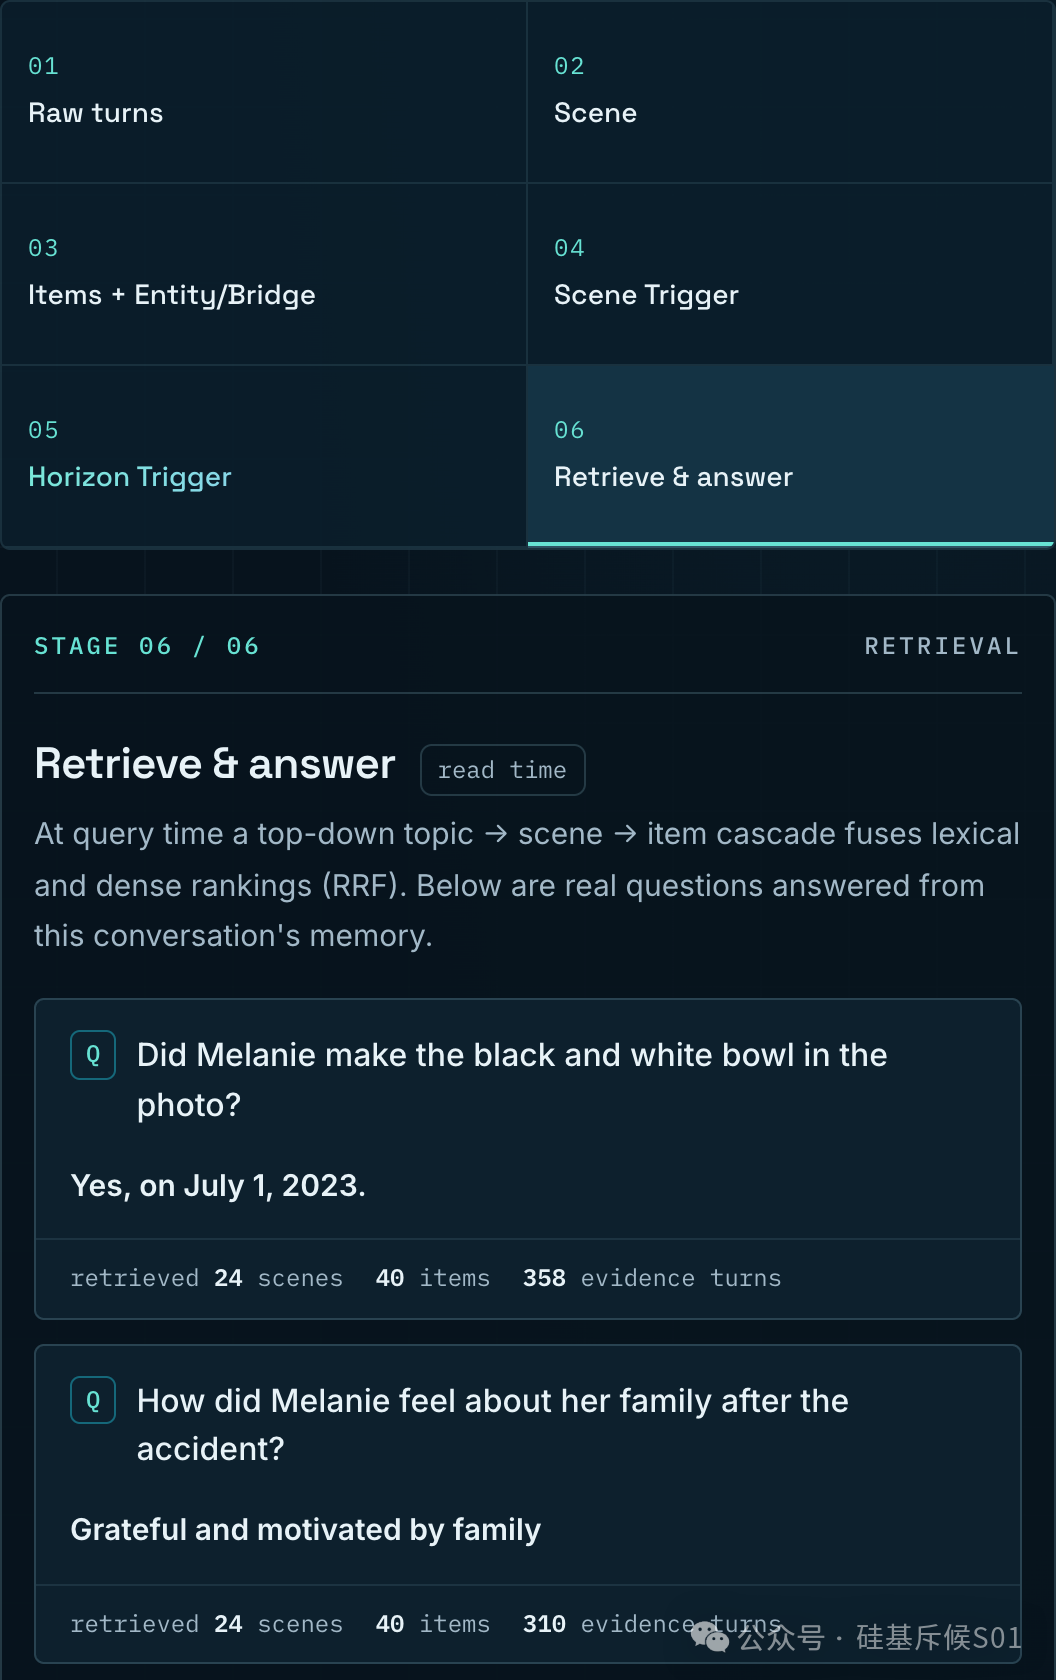
项目自带的演示页,展示了问题、答案,以及找回的场景、事实和原话数量。下图是项目预先保存的运行结果。
使用过程中,还要区分“帮忙找东西的线索”和“可以相信的事实”。
“以后可能需要准备离线安装包”是系统提前想到的一种用法。如果把它直接当成事实,回答就可能变成“安装包已经准备好了”。
T-Mem 为此做了分工:这些线索,代码里叫触发器,主要负责找回材料;回答模型读取的是相关场景和事实。联想可以帮助查找,但发生过什么,要由找回的材料支持。
这能减少把猜测写进回答的问题。不过,默认流程也可能使用整理后的摘要,摘要本身仍可能漏掉条件。涉及客户承诺或重要限制时,能回查原话,依然很有用。
论文里值得关注的内容
我看了一下论文,它做了一组对照:保留完整的 T-Mem,再去掉负责前瞻联想的 Horizon 模块,看看成绩怎么变。
在更关注隐含关联的 LoCoMo-Plus Cognitive 测试中,完整方案得分 74.81%,去掉这一模块后降到 62.34%,相差 12.47 个百分点。
这组结果支持它的主要价值:当新问题没有直接提醒旧信息时,提前准备使用线索,确实能帮助系统把相关内容找回来。
我觉得有三件事可以借鉴,做工作助手或整理自己的项目资料时都能试。
第一,给重要信息补一句“什么时候会用到”。 客户限制旁边写上适用的工作,例如部署、升级或验收;项目复盘里的教训,注明下次什么任务要检查。先整理那些漏掉后容易返工的信息,不必为每句话都做联想。
第二,让整理后的结论能找到原始依据。 一条记忆保留对应的会议记录、原话和时间。以后信息有变化,事实与使用线索一起更新;拿不准时,回到原始材料确认。
第三,测试时故意少提醒一句。 先告诉助手一个限制,隔几轮再安排相关任务,看看它能否主动用上。同时检查它有没有把别的客户、别的项目的限制带进来。这样测,能看出它是否在合适的时候使用了合适的记忆。
不过T-Mem 目前也有明显的代价。
首先是写入成本。论文报告,10 段长对话的完整记忆构建,用了 9,689 次模型调用,共处理约 1,560 万 tokens。把未来用法提前想一遍,需要额外计算;所以如果只是简单问答,就得掂量掂量成本了。
还有联想的质量。线索太宽,容易带来无关记忆;线索想偏了,又可能漏掉真正需要的内容。这也是为什么,评估时要同时看“该想起的有没有想起”和“不该带进来的有没有混进来”。
更主要的问题是更新。客户的环境会变,人的目标也会变。论文将增量更新和记忆整合列为后续工作,当前公开实现仍以离线构建和评测为主。中文工作场景的效果,也还需要进一步验证。
不过总的来说,记忆联想和触发器确实给了我一些启发,我也许会优先在知识库等这类会反复检索资料的产品上尝试这套思路。
以上就是这次的侦察。
如果对你有用,顺手点个赞 +「♥️」。
想第一时间收到前线情报,关注「硅基斥候S01」。我们,下次侦察见。