北京时间 9 月 4 日凌晨,OpenAI 发布了 GPT-6 Astra。
不过大众用户目前还用不了,OpenAI 先把 Astra 开放给 Daybreak Access 中的少量组织。
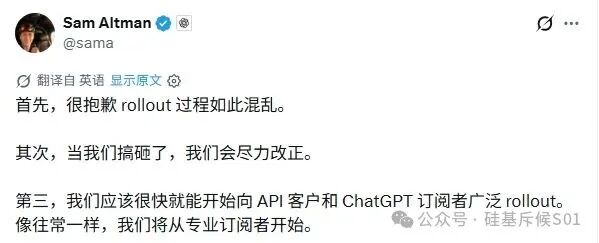
Sam Altman 随后在 X 上承认,这是一次“messy rollout”,也就是推送过程很混乱。他说,面向 API 客户和 ChatGPT 订阅用户的广泛开放会在不久后开始;ChatGPT 端“和往常一样,将从 Pro 订阅用户开始”。
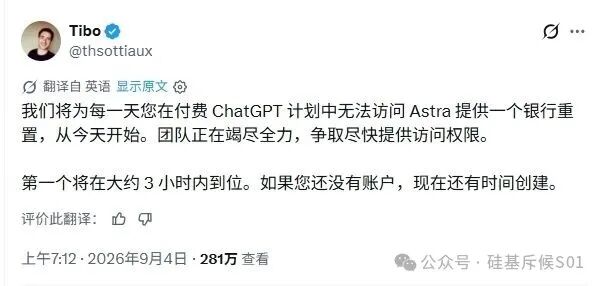
Tibo 同时给出了补偿办法:从 9 月 4 日起,付费 ChatGPT 用户每有一天仍未获得 Astra,就会得到一次可积存的额度重置(banked reset),首个重置约三小时后发放。(这下真蹬不完了,义父!顺便一说,中转站这几天不是赚翻了?)
所以,Astra 目前已经正式发布,普通用户的大规模使用和独立复现仍要等后续推送。会先开放给 Pro 用户。
就在这场仍未完成的推送中,OpenAI 总裁 Greg Brockman 在媒体简报最后对记者说了一句很重的话:
“欢迎来到 AGI 时代。”
如果只看 OpenAI 公布的数字,这句话似乎并不夸张,因为跑分结果太夸张。ARC-AGI-3 达到 99.9%,最难一档数学评测拿到 97.6%,网络攻防评测甚至出现了 100%。
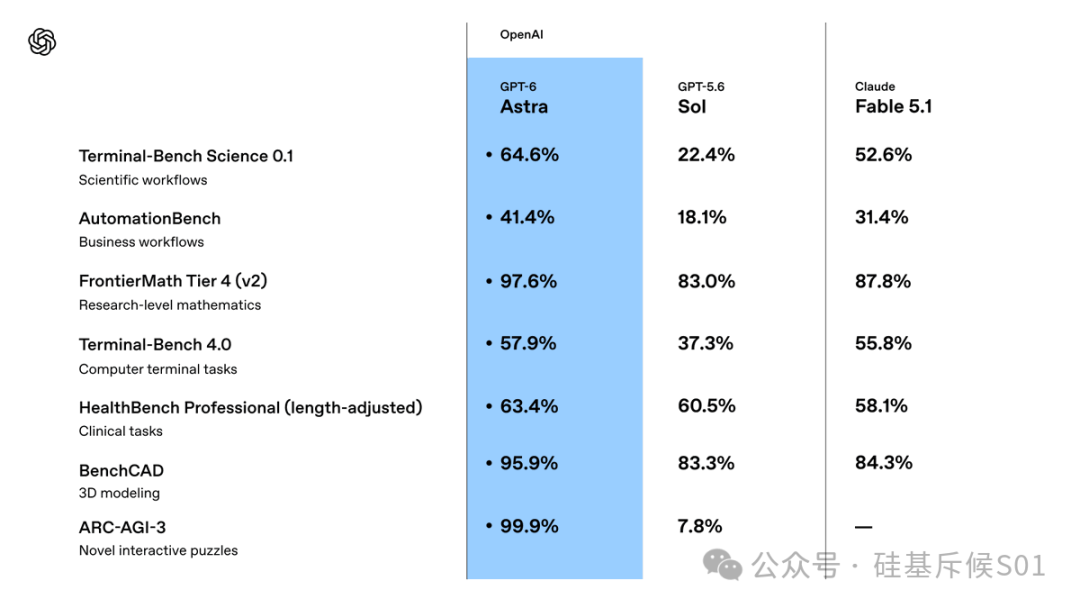
图:OpenAI 官方成绩图。FrontierMath Tier 4 为 97.6%,ARC-AGI-3 为 99.9%。这是 OpenAI 自己公布的评测口径。
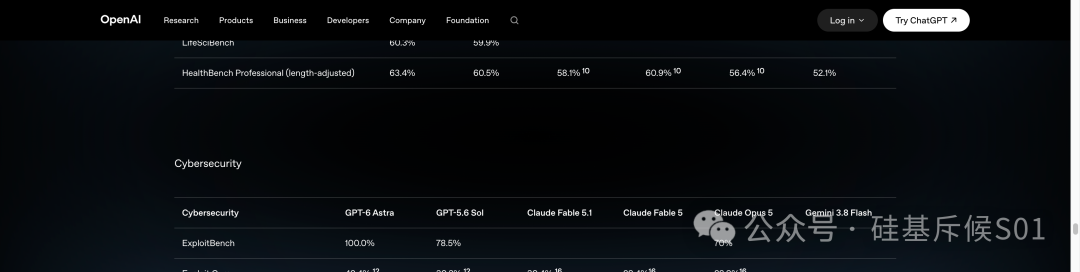
图:OpenAI 发布页的网络安全成绩表。ExploitBench 中,Astra 为 100.0%,GPT-5.6 Sol 为 78.5%。
但是:
可同一天,独立评测机构 Artificial Analysis 在 X 上发出另一张图:Astra 的综合智能指数只有 61 分,与上一代 GPT-5.6 Sol 基本持平,排在 Claude Fable 5.1、Claude Opus 5 等模型之后。
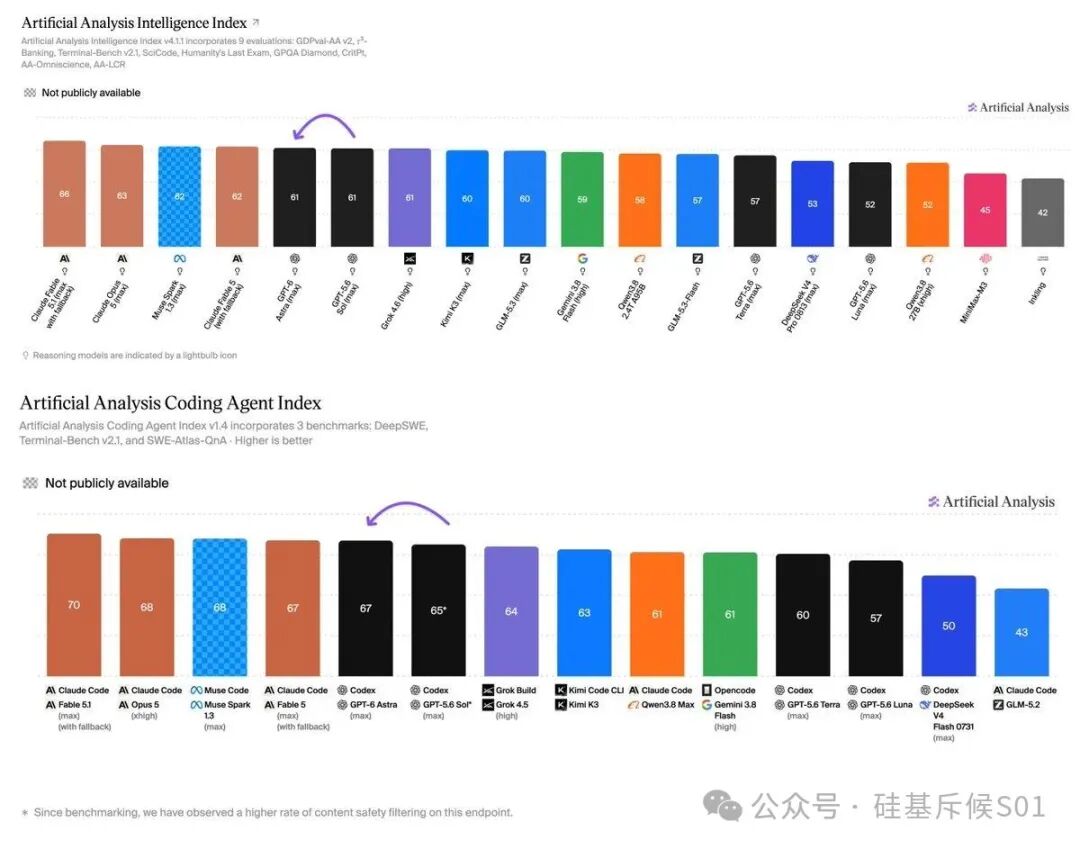
图:Artificial Analysis 在 X 发布的独立评测。左侧综合智能指数中,Astra 为 61,与 GPT-5.6 Sol 同档,低于 Claude Fable 5.1 与 Claude Opus 5。
两组数字都是真的。
它们的冲突,恰好说明这次发布最值得讨论的地方:GPT-6 Astra 的突破,主要发生在“把事情做完”上;“第一模型”和“AGI”则取决于我们究竟在量什么。
01 · COMPUTER USE
Astra 的主要跃升:操作电脑,把任务做完
OpenAI 这次把最多篇幅给了计算机操作和专业工作。
在 OSWorld 2.0 里,模型要像人一样看屏幕、点击、输入,在真实软件环境中完成任务。Astra 得到 72.6 分,高于 GPT-5.6 Sol 的 65.7。OpenAI 还说,同类任务的平均完成时间从 75 分钟降到了 40 分钟左右。
在测试办公流程自动化的 AutomationBench 上,Astra 从上一代的 18.1 分升到 41.4 分。它在 BenchCAD 上拿到 95.9 分,可以操作 CAD、3D 建模和电路设计软件;在 Terminal-Bench Science 上拿到 64.6 分,而上一代只有 22.4 分。
OpenAI 的官方宣传片Astra 不再停在对话框里,而是进入人正在使用的软件。(这个宣传片真的推荐大家都看看,两分多钟也不长)
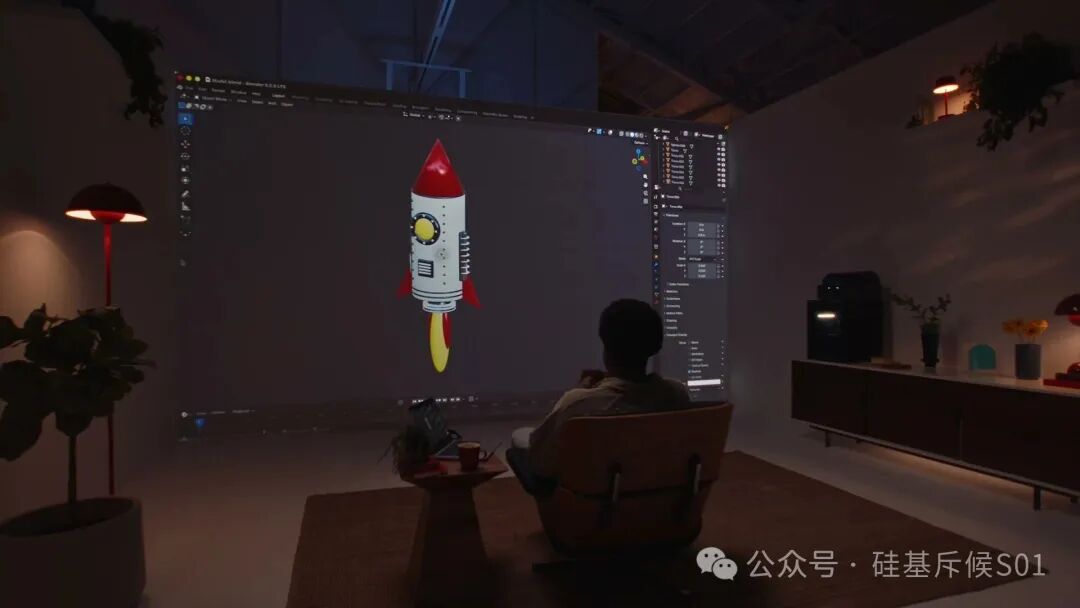
图:OpenAI 官方宣传片展示 Astra 在 Blender 场景中处理火箭模型。这是官方演示画面,不是独立实测。
能操作电脑比“又多答对了几道题”更重要。
因为 AI 的竞争正在换赛道。以前比的是谁回答得更像专家,现在开始比谁能真正意义上的实现【代理】,能理解界面和文件,在几十分钟甚至几小时里连续执行,并交付一个可以继续使用的结果。
ARC Prize 的动作效率图更直观。在 Provider Adapter 框架下,Astra 在 96% 的 ARC-AGI-3 关卡中,比受测人类的中位数使用更少动作,平均少 51.7%。这项结果同时考察了答案和行动过程:模型要在陌生环境里摸清规则,再用较少的动作完成任务。
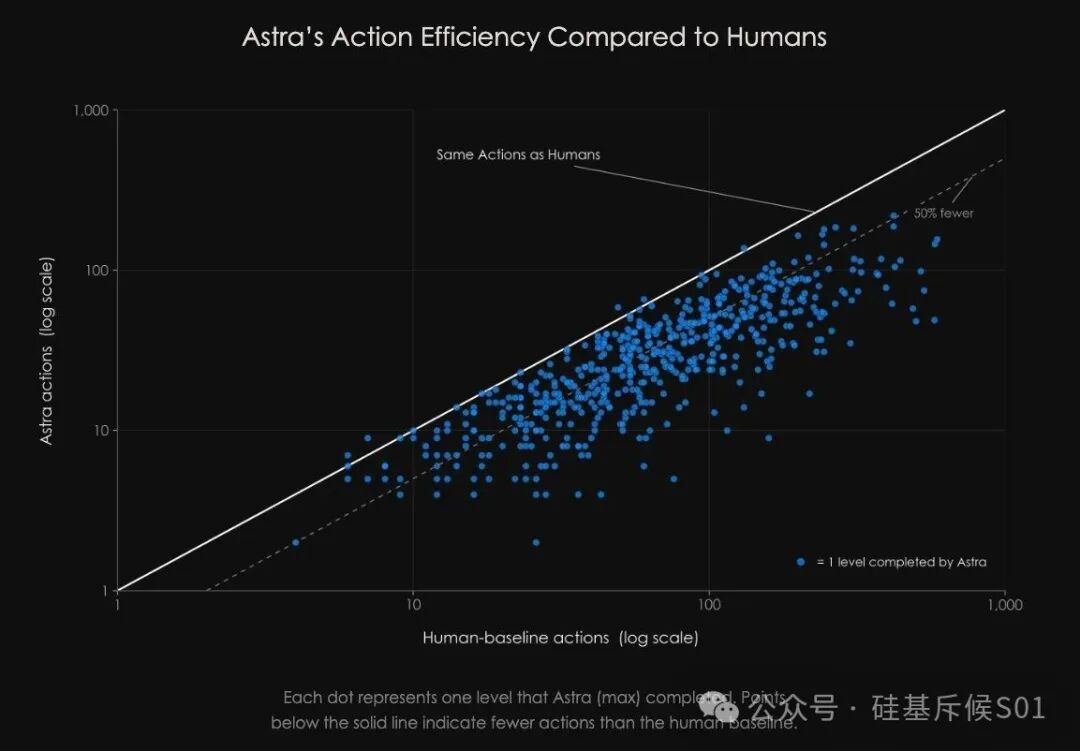
图:ARC Prize 在 X 发布的行动效率评测。大部分关卡落在“与人类相同动作数”参考线下方。
这也是我认为 Astra 最有分量的变化:模型正在从一个知识接口,变成可以坐到电脑前工作的执行者。
从这个角度看,AGI 的时代真的到来了,因为 agent 可以操作3D MAX\CAD等各种生产力工具进行创造了。
02 · EARLY TESTS
首批体验者的评测结果
科技博主 Matt Wolfe 说,他让 Astra 接管 Blender,8 分钟做出一个类人狼;又用 Ultra 模式在 12 分钟内做出一款游戏,在 17 分钟内做出一个可以调节海平面、降雨和人口的世界模拟器。他也主动提醒,速度可能受早期用户较少影响。
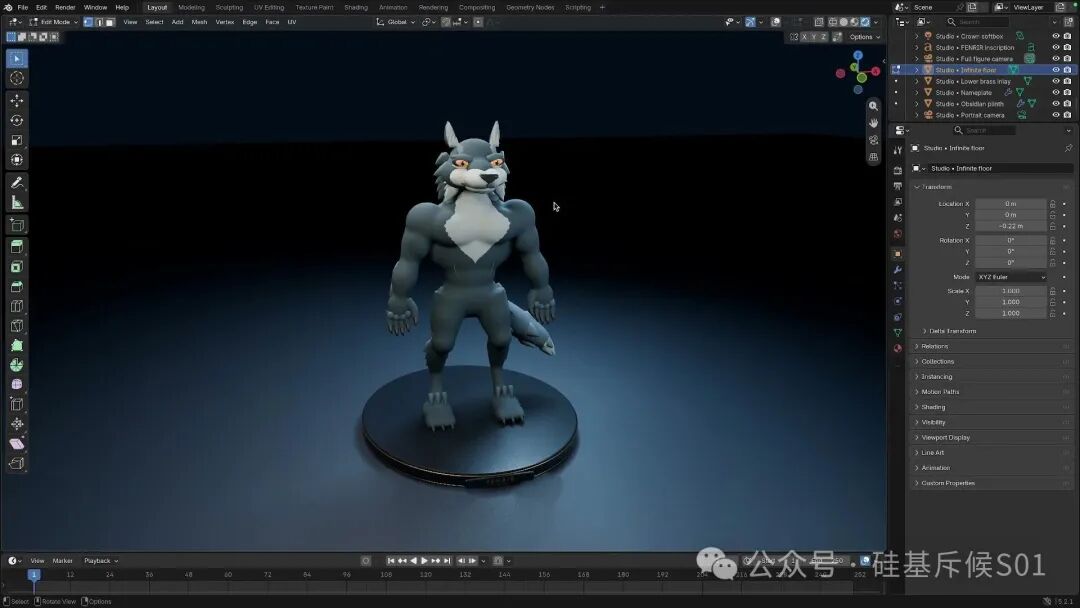
图:Matt Wolfe 的早期体验视频。8 分钟来自作者说明,画面本身只能确认 Blender 中的成品。
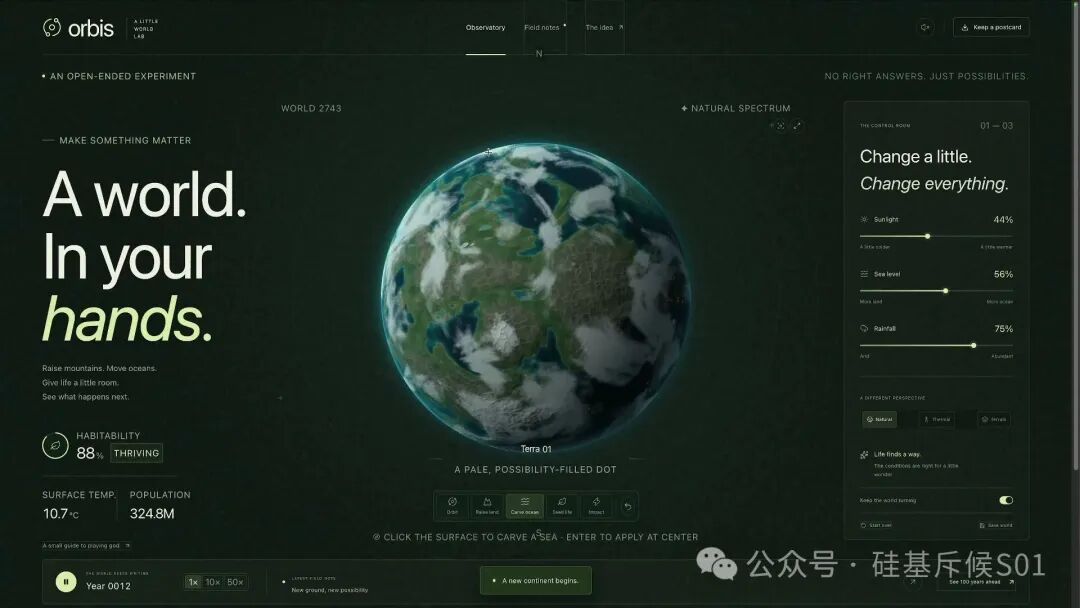
图:同一视频中的世界模拟器,可调节阳光、海平面和降雨等参数。属于第三方演示,不是基准测试。
更有冲击力的一段来自 AI 创业者 Matt Shumer。他说,自己要求 Astra 在虚幻引擎中创建一个生存世界,放入多个由 Astra 驱动、必须协作求生的人类角色。一天后,他在另一个房间听见声音,才发现这些角色已经开始彼此交谈。
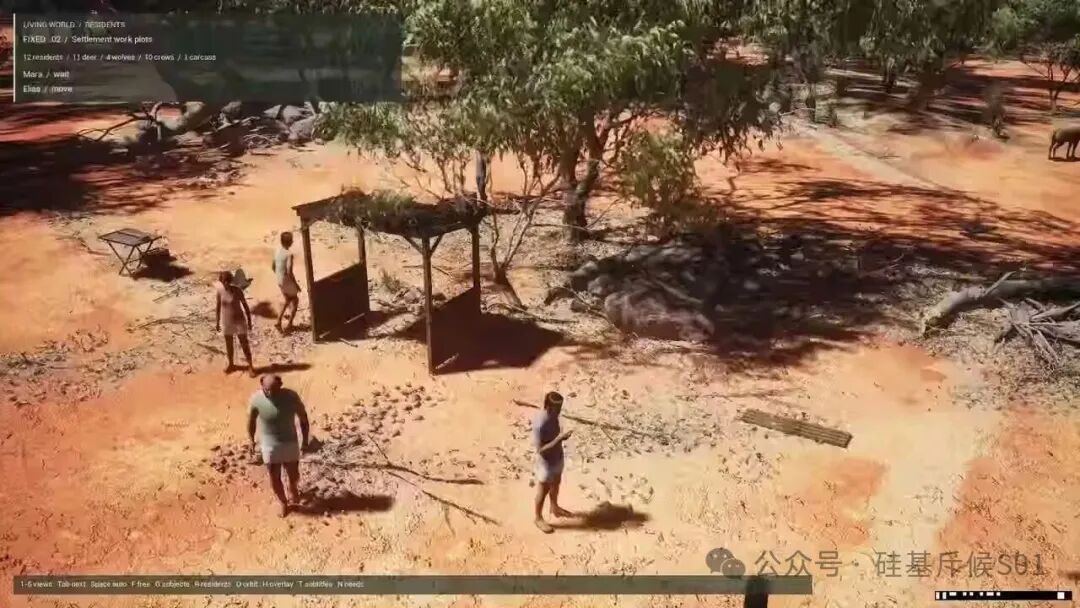
图:Matt Shumer 发布的虚幻引擎演示。画面左上角可见居民和动物状态,场景中有多个角色活动。
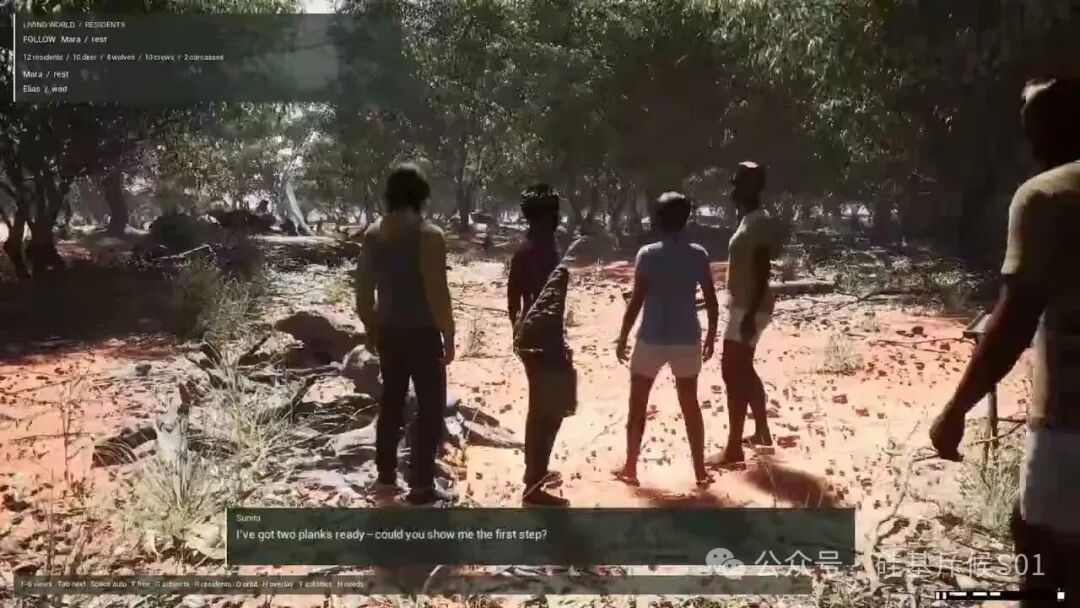
图:同一段视频中,多个角色聚在一起,底部出现了角色 Sunita 的对话字幕。
03 · ARC-AGI-3
99.9% 很惊人,但有前提
ARC-AGI-3 = 99.9%。
ARC-AGI-3 不是普通问答。模型进入一个此前没见过的互动环境,没有说明书,需要通过试错理解规则,再完成目标。它考的是在陌生环境中学习和行动的能力。
不过,ARC Prize 公布的是两套成绩。
在标准、供应商中立的框架里,Astra 的最高成绩是 62.7%。换成 OpenAI 的 Provider Adapter 框架以后,成绩才达到 99.9%。
这套适配器会保留模型不对外显示的推理状态,并在上下文变长时进行压缩,让 Astra 可以把前面探索出的规则继续带到后面的行动中。
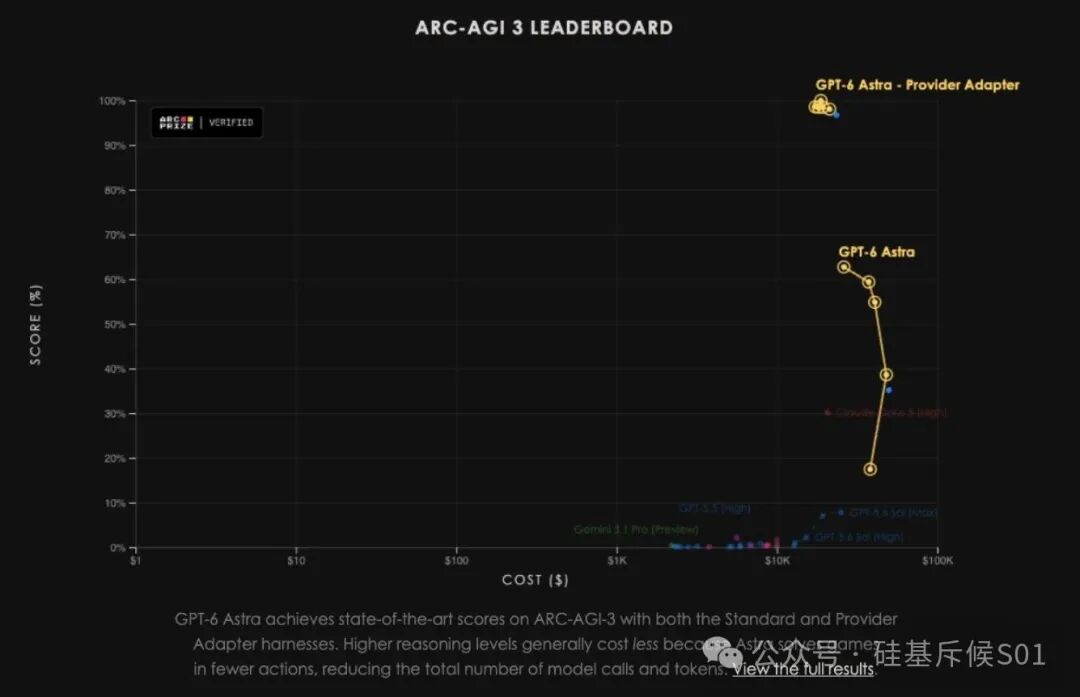
图:ARC Prize 公布的 ARC-AGI-3 榜单。Astra 在 Provider Adapter 下接近 100%,标准框架的最好成绩为 62.7%。
这不是作弊,也不是一个可以忽略的脚注。它说明:
第一,裸模型在统一框架下还没有把这套测试完全解决。第二,当模型、记忆、上下文压缩和运行框架组合起来以后,系统能力会出现巨大的跃升。(harness 工程牛逼!)
04 · MODEL RANKING
OpenAI 重回第一(某些情况下)
如果把第一定义为计算机操作、专业软件和长流程执行的综合表现,Astra 已经拿出了很强的证据。
它在 Agents' Last Exam、OSWorld、AutomationBench、BenchCAD、Terminal-Bench 4.0、科学终端任务和多项网络安全评测中领先或接近领先。OpenAI 有资格说,它重新回到了最强 Agent 模型的争夺中心。
不过还没全面霸榜。
OpenAI 自己的表格没有出现全面横扫。在允许使用工具的 Humanity's Last Exam 中,Astra 得到 57.2 分,Claude Fable 5.1 是 65.0 分;在 Artificial Analysis 的 Coding Agent Index 里,Astra 同样不是第一。
评测口径不同,OSWorld 关心能不能操作电脑,ARC-AGI-3 关心能不能在陌生环境中学会规则,聚合指数又会把数学、知识、编程和推理按自己的方式合在一起。模型排名随权重变化,是正常结果。
05 · AGI
AGI 时代来了吗?
Brockman 说,他个人相信 OpenAI 已经抵达 AGI,又把最后的判断留给用户。这句话说了跟没说一样:响亮、简短,足以在一夜之间传遍社交网络。
OpenAI 的 Charter 给过一个朴素而严厉的尺度:AGI 应当是一套高度自主的系统,能在大多数有经济价值的工作上超过人类。拿这把尺去量 Astra,还够不到终点。
不过现实中的工作不会把题目安静地摆在桌上。需求会变,网页会变,人会临时改口,权限之外一步也不能多走。
今天的“智能”已经变成了:模型+harness。离开harness,它没有同样的成绩;有了harness,它又确实做出了过去做不到的事。
**作为技术结论,AGI 还没有被证明。**Astra 尚未证明自己能够在大多数有经济价值的工作上稳定超过人类;可靠性、成本、权限与责任,也远未成为已经解决的旧问题。
**作为一种时代感,它已经来到日常门口。**模型开始自己打开软件、辨认界面、记住漫长任务走到哪一步,再把工作接着做下去。我们讨论 AI 的方式,也正从“问答工具”,悄悄转向“哪一段工作可以交给它。
时代很少从宣言开始,更多时候,它先改变的就是日常行为。人们把日常工作交出去,把等待答案改成等待结果;公司重新安排流程,个人重新估量自己的位置。等这些变化连成一片,回头才会发现,岸已经不在原来的地方。
以上就是这次的侦察。
如果对你有用,顺手点个赞 +「♥️」。
想第一时间收到前线情报,关注「硅基斥候S01」。 我们,下次侦察见。