对于当前最先进的模型来说,一些过去用来防止模型出错的要求,可能已经开始妨碍它做事了。
以前的模型容易漏步骤、选错工具,多写一些提醒确实有用。但换了模型以后,有些问题已经能由模型自己处理。
OpenAI 建议先检查 Skills 到底用在什么地方
用 Codex、hermes、Workbuddy 等Agent 工具的人,可能已经有了 AGENTS.md 这类文件记录项目约定,也安装了不少的 Skills。
在 Agent 工具里,模型先看到技能的名字和描述,决定使用后才读取完整说明。技能装得多、描述又长时,描述可能被缩短,模型就更难判断该选哪个。
OpenAI 用数据库迁移技能举例。它本来只该在增加、修改迁移文件或审查上线过程时使用,描述却把数据库、查询、数据模型都写进了适用范围。这样连普通查询也可能把迁移流程叫出来。
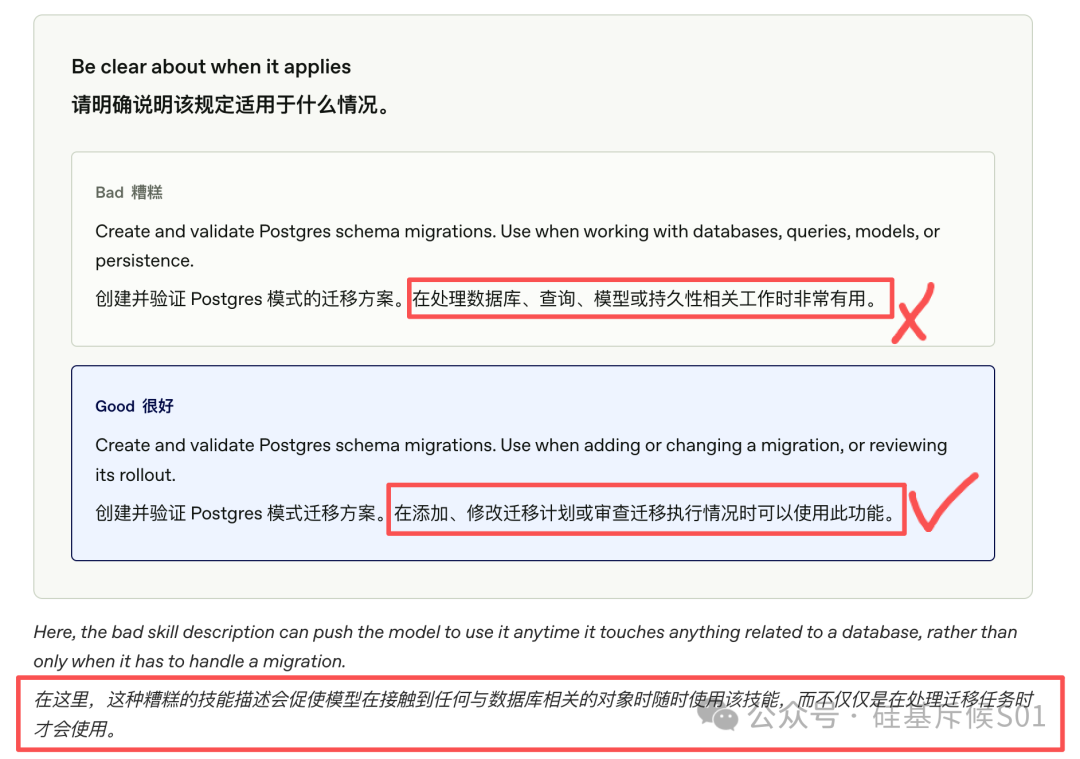
一次查数据的任务,和一次会改变数据库结构的操作,需要考虑的事情差得很远。后者可能要检查已有数据怎么办、变更失败能不能恢复。把这些要求无差别地放到前者身上,任务还没做,工作量就先被放大了。
技能里的资料也应当分开存放,需要时再读取。入口保留适用范围和查找线索,详细步骤、脚本、模板放在相应文件里。
比如只想从一份文档里取出几段文字,就没必要把最终排版的模板和检查流程也读进来。等到要交付排版好的文档,再读取那些资料。
明确模型终止条件(或者说你要明确你的目标)
OpenAI 也提到,GPT-6 Astra 在何时停止处理任务时可能会更加谨慎,它可能会先完成初步的实施阶段,然后再回来请你审核结果。
如果需要它把功能运行起来、检查结果、继续修复等一系列动作,那就把这些写进完成条件里。
假设让 AI 做一个文件导入功能,代码写完以后,文件能不能选、数据能不能正常导入、出错时有没有提示,都还需要检查。用户可以把这些结果要求说清楚,具体查哪个文件、先改哪里,让模型根据实际情况处理。
原文还建议,把已知安全的工作授权写具体。例如本地测试使用一次性数据、不接触生产环境,就可以明确允许模型运行测试、修复本次改动造成的失败,再复测相关部分。
至于测试,OpenAI 表示 Astra 已经会主动检查工作,旧提示词中反复催促测试的要求可能带来多余检查。该检验哪些行为、什么结果算通过,需要结合这次改动判断。
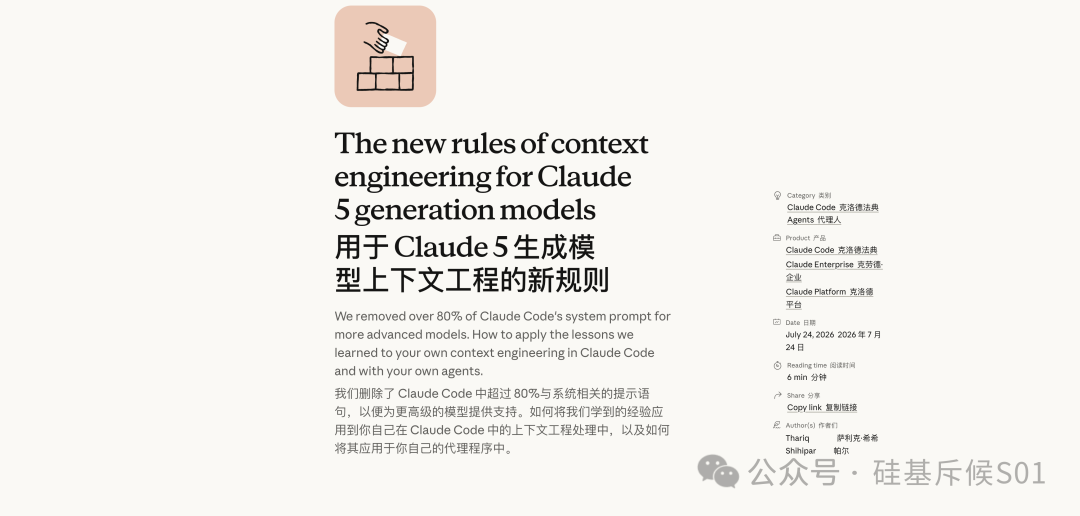
其实不止 OpenAI 有这方面的理论,Anthropic 在 2026 年 7 月的时候就有相关文章,针对 Claude Opus 5、Claude Fable 5 等模型,他们移除了 Claude Code 超过 80% 的系统提示词,在其编码评估中没有发现可测量的性能下降。
我现在更像一个测试人员
作为一个产品经理,我现在根本不需要先做很详细的产品功能设计。 即使脑子里对一个功能的想法还没那么完善,我也先交给 AI 开发,做出来再测试。
发现问题就指出来,也不用告诉它应该怎么改。它会去解决,而且我觉得它考虑得比我还完善。
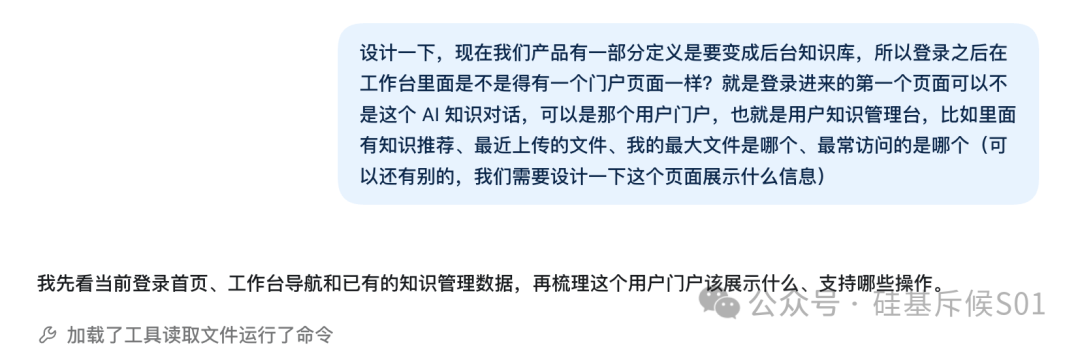
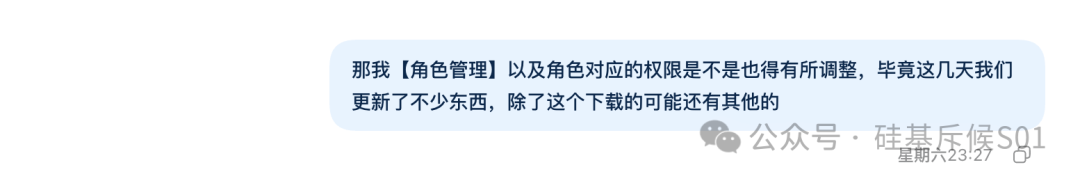
两张我跟 Codex 对话的记录,可以看出我并没有给它下达具体的功能设计,比如那个门户页面具体应该展示哪些信息,如何布局,【角色管理】权限到底怎么分配,我只是说出需求、指出问题即可。
我只需要评审验收它的最终成果,可以更专心地看这个功能用起来对不对,问题有没有解决,是否符合我要的东西。
把想清楚的目标留下,把没必要的步骤拿掉
我最近也重新整理了自己的 AGENTS.md 和 Skills。
项目里那些 AI 猜不到的约定,当然还得告诉它,要做什么、做到什么程度算完成也得说清楚。数据保护、事实核查、必要的测试,以及对外操作的授权要求,都值得保留。
不过如果是在做多人协同项目的时候就需要注意了。同一项目里,不同人可能用着不同模型,某条提醒对一个模型已经多余,对另一个却还有用。
下次换了模型,可以拿几个常做的任务再试试旧规则,比较它有没有遗漏要求、能否完成必要检查,哪些步骤只是白走了一遍。
哪条还在帮它少犯错,就继续留着;哪条只让它多走无用的步骤,就改掉。
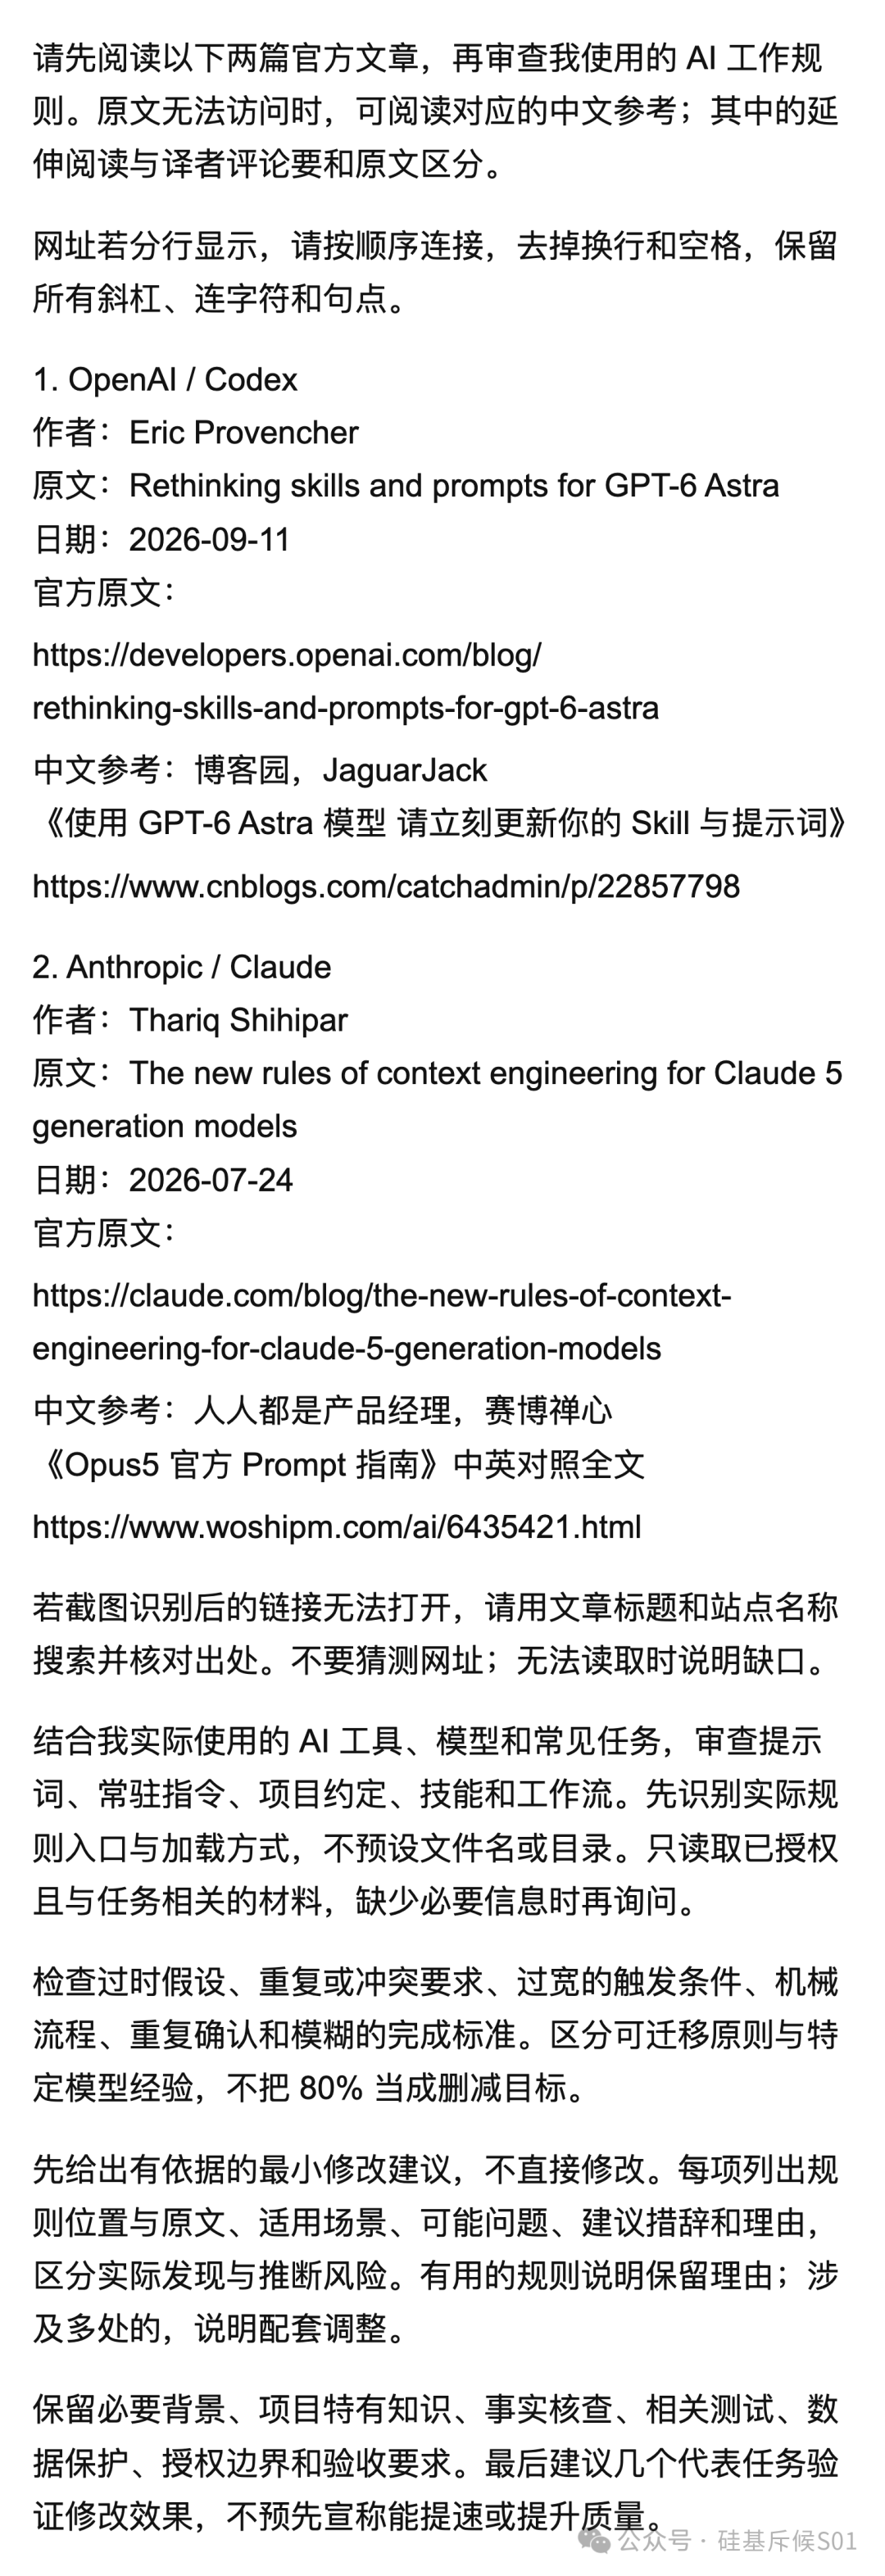
附:可以把下面这段交给你使用的 AI 助手,让它参考两篇原文,检查现有规则。
以上就是这次的侦察。
如果对你有用,顺手点个赞 +「♥️」。
想第一时间收到前线情报,关注「硅基斥候S01」。我们,下次侦察见。