OpenAI 正在逐步兑现它的承诺:让 AI 惠及普罗大众。
今天凌晨,OpenAI 发布了 GPT-6 Sol 和 GPT-6 Luna,为本月推出的 GPT-6 增加了两档更便宜的选择。
Sol 面向复杂编程和多步骤任务,Luna 侧重任务明确、调用量大的应用。
这次最主要的变化是价格:同样的输入和输出用量,Sol 的标准 API 费用是 Astra 的五分之一,Luna 则是百分之一。
是的,你没有看错,luna 的价格已经降到和小米
便宜之后,交出来的东西怎么样?官方已经公布多项跑分,第一批用户也晒出了作品。
Sol 价格减半,Luna 每百万输出 token 只要半美元
目前三款 GPT-6 的标准文本 API 价格如下。Token 是模型处理文字时使用的计量单位,表中均为每百万 token 的美元价格,适用于输入不超过 27.2 万 token 的普通请求。
模型
输入
输出
GPT-6 Astra
10 美元
50 美元
GPT-6 Sol
2 美元
10 美元
GPT-6 Luna
0.10 美元
0.50 美元
对比上一代的价格,Sol 的输入和输出单价都降低了 50%;Luna 输入降了 50%,输出从 1.20 美元降到 0.50 美元,降幅约 58%。
OpenAI 同时宣布,两款模型开始向 ChatGPT Work 和 Codex 的 Plus、Pro、Business、Enterprise、Edu 用户开放;Free 和 Go 用户可在桌面应用中使用 Luna。
官方跑分:Sol 做复杂任务,Luna 的编程成绩也不低
OpenAI 这次公布的测试,覆盖跨应用办公、软件工程和电脑操作。下面挑几项有明确数字的成绩;high、xhigh、max 是不同的推理档位,档位越高,通常允许模型多花计算来解题。
AutomationBench 1.0.6
跨应用完成业务流程
Sol(xhigh)33.2%
Agents’ Last Exam V1
较长、较复杂的专业工作
Sol(max)56.4%
DeepSWE 1.1
在真实代码库中完成软件工程任务
Sol(max)68.8%;Luna(max)66.6%
OSWorld 2.0 offline
操作电脑完成工作流程
Sol(xhigh)60.5%
有一些能力,甚至和Astra相当。
例如 AutomationBench:Sol 的 33.2% 高于 Astra low 档的 30.3%,每题成本约 0.27 美元,后者约为它的 3.9 倍。Luna 在 high 档较上一代提高了 5.4 个百分点,每题费用下降 58%。
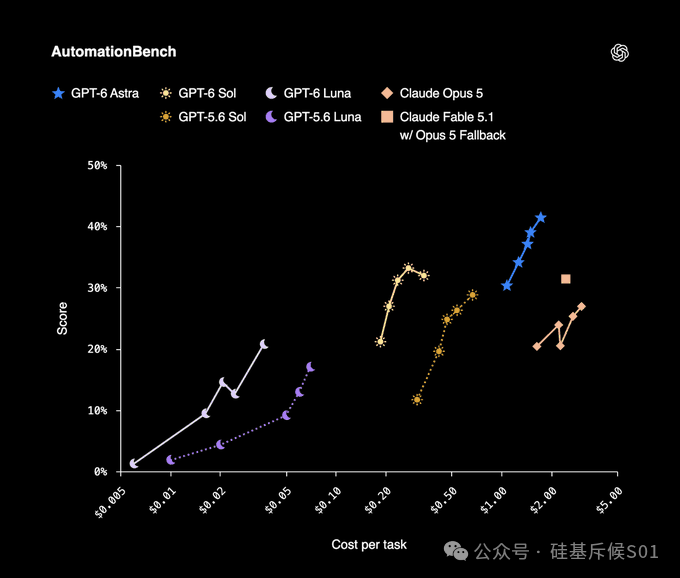
图中横轴是每题费用,纵轴是成绩。同一家族的不同点对应不同推理档位。
机构独立跑分:Sol 小涨,Luna 有退步
Artificial Analysis 用 Codex 运行模型、统一取 max 档,得到的编程 Agent 指数如下。这个指数综合了软件工程、终端操作和代码问答三项测试。
模型
编程 Agent 指数
上一代 同名模型
GPT-6 Astra
62
—
GPT-6 Sol
57
55
GPT-6 Luna
41
43
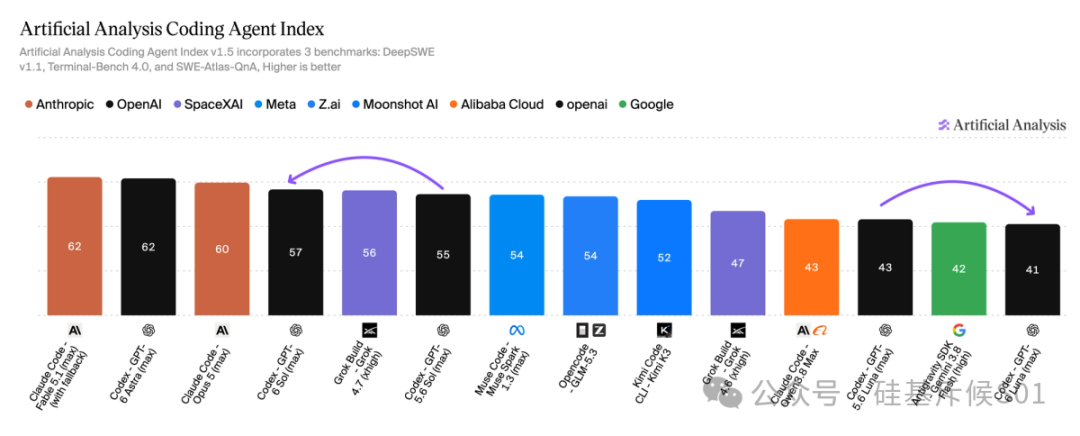
Sol 涨了 2 分,Luna 降了 2 分;完成编程测试的每题成本,两者分别比上一代降低约 50% 和 60%。这和官方的主打方向相符:费用降得很明显,能力改善则要分任务看。
这家机构还检查了数百份办公任务输出,发现部分评测的退步与成品呈现质量、遗漏交付要求有关。
网友实测:鹈鹕和旋转木马
**Simon Willison **这位开发者他说已把 Codex 默认模型换成 Sol,还把 Datasette Agent 演示应用升级到 Luna。查询数据库、生成 HTML 和 JavaScript,是他给出初步好评的实际场景。
他也公开了多档位的绘图结果。下图截取的是三个 GPT-6 模型的 max 档,从左到右为 Astra、Sol、Luna;下方保留了他记录的 token 用量与费用。
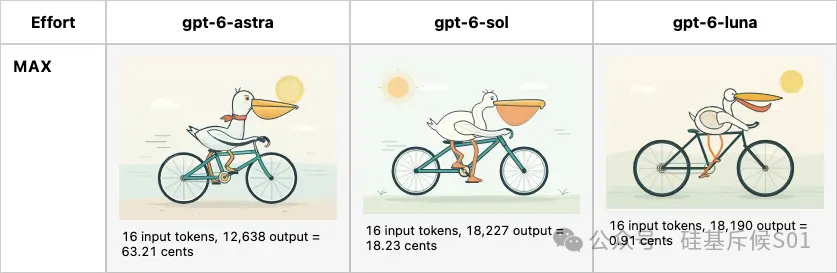
其实Luna 这张也还行,长嘴、颈部和骑行姿态都能认出来,图中记录的费用还不到 1 美分。可惜我后面自己测的时候,Luna 就没这么争气。
再看 BitsMinds 的海边游乐场。 它让模型用代码画出摩天轮、旋转木马和水面倒影。上面是 Sol,下面是 Luna。
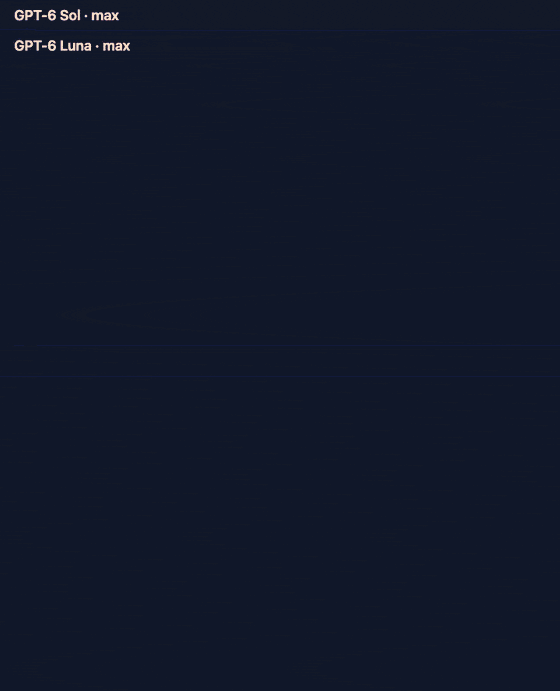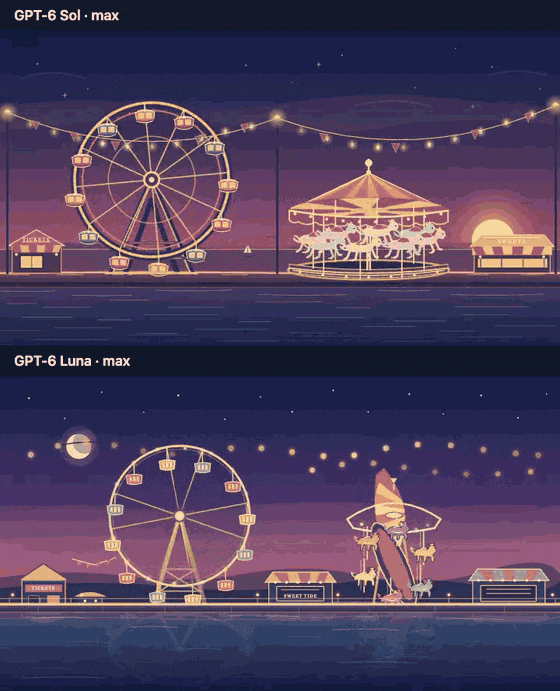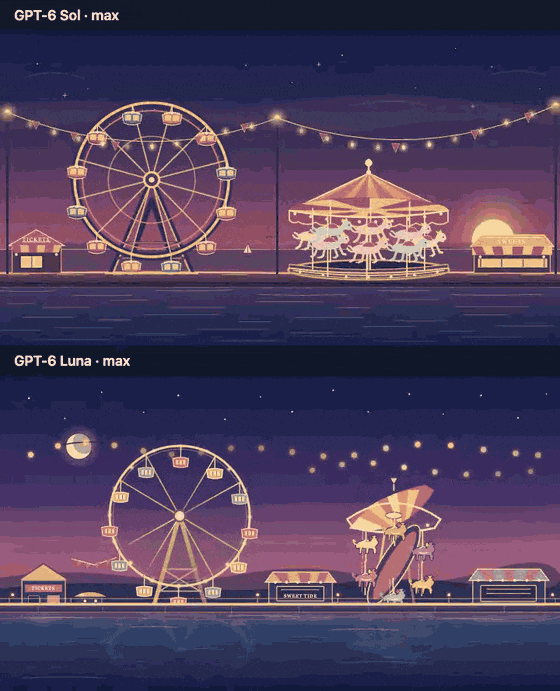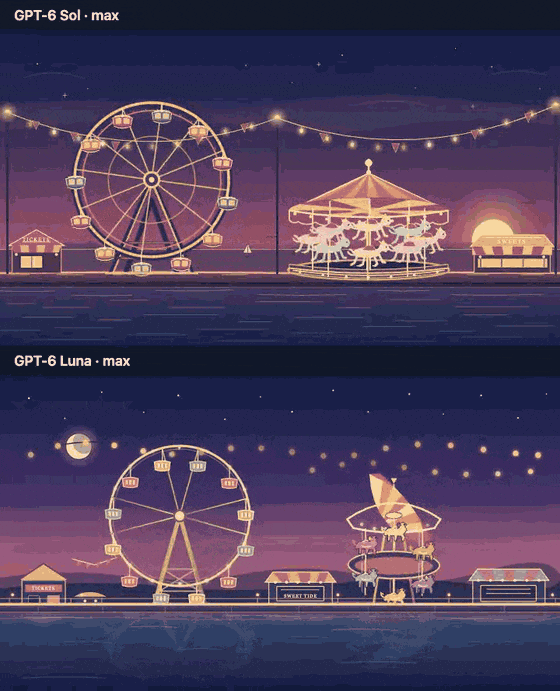
这木马的票,我反正不敢买。
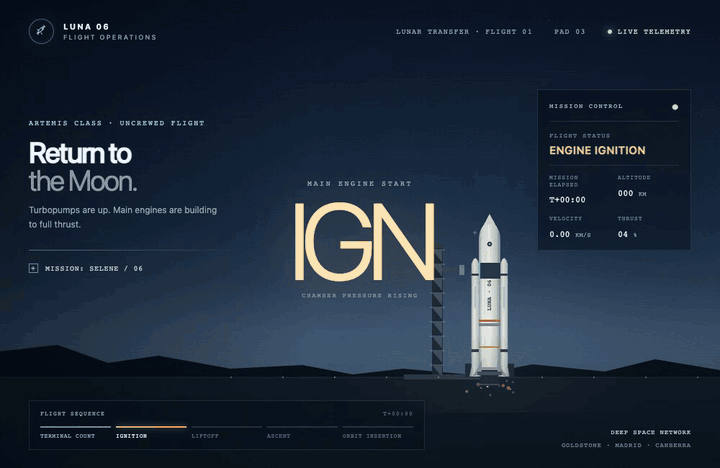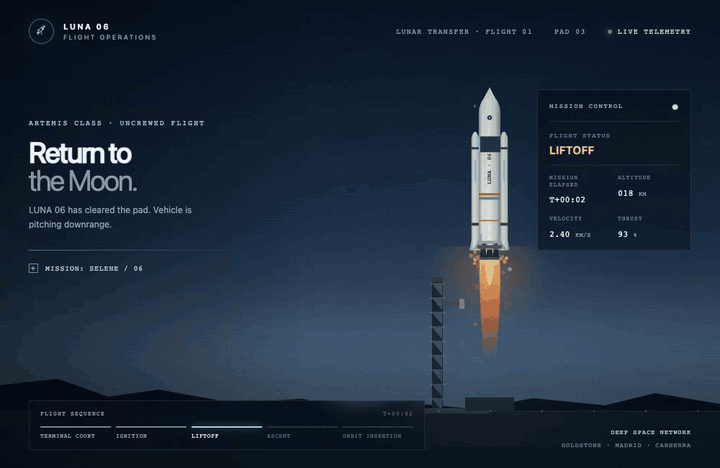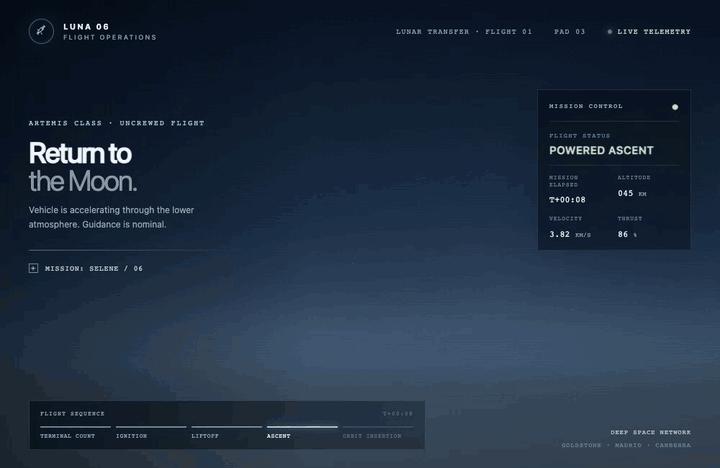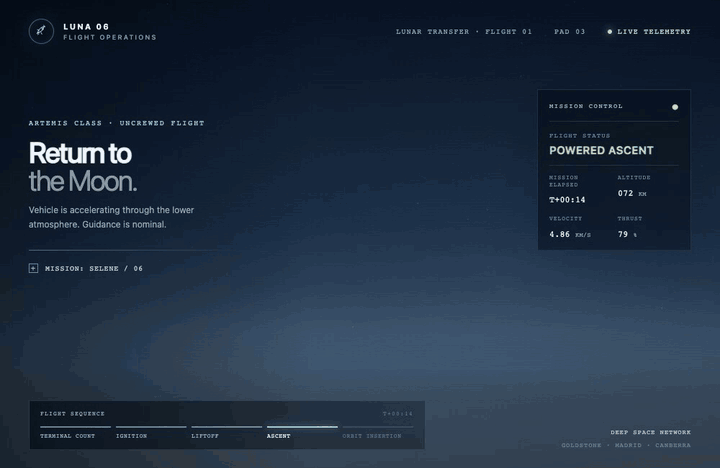
Luna 的火箭网页。 前半段看着挺像回事,飞了一小会儿,火箭却看起来是往画面下方滑,最后直接消失,而旁边的仪表盘仍在报告高度和速度。
亲自实测,我也让三个模型各画了一只鹈鹕
这次我在 Codex 中分别调用 Sol、Luna 和 Astra,统一使用 high 推理档位,各生成一次。三个独立会话都没有参考图,也不预览或修正自己的输出。
提示词用的是同一句:
Generate an SVG of a pelican riding a bicycle.
也就是“生成一幅鹈鹕骑自行车的 SVG”。
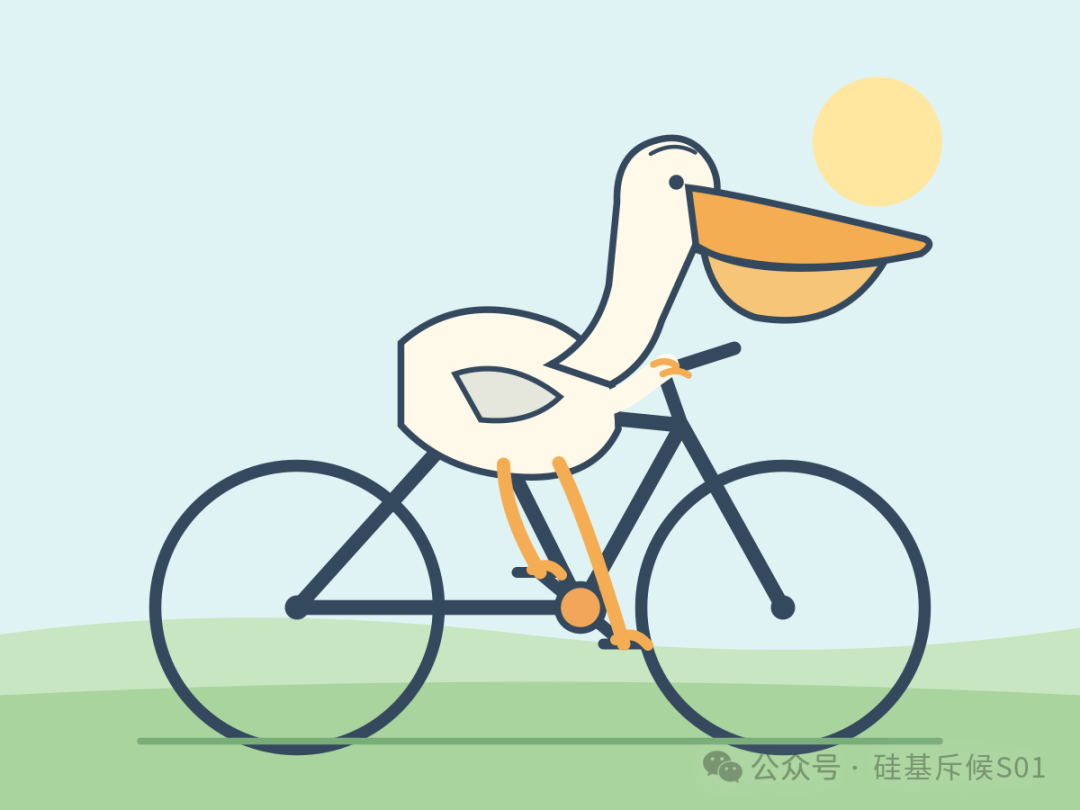
先看 Sol。 长嘴、喉囊和颈部连得上,双脚也落在踏板附近。它用了很少的细节:车轮没有辐条,车体没有链条,鸟的轮廓也比较简化。作为一张简单插画,题意是完整的。
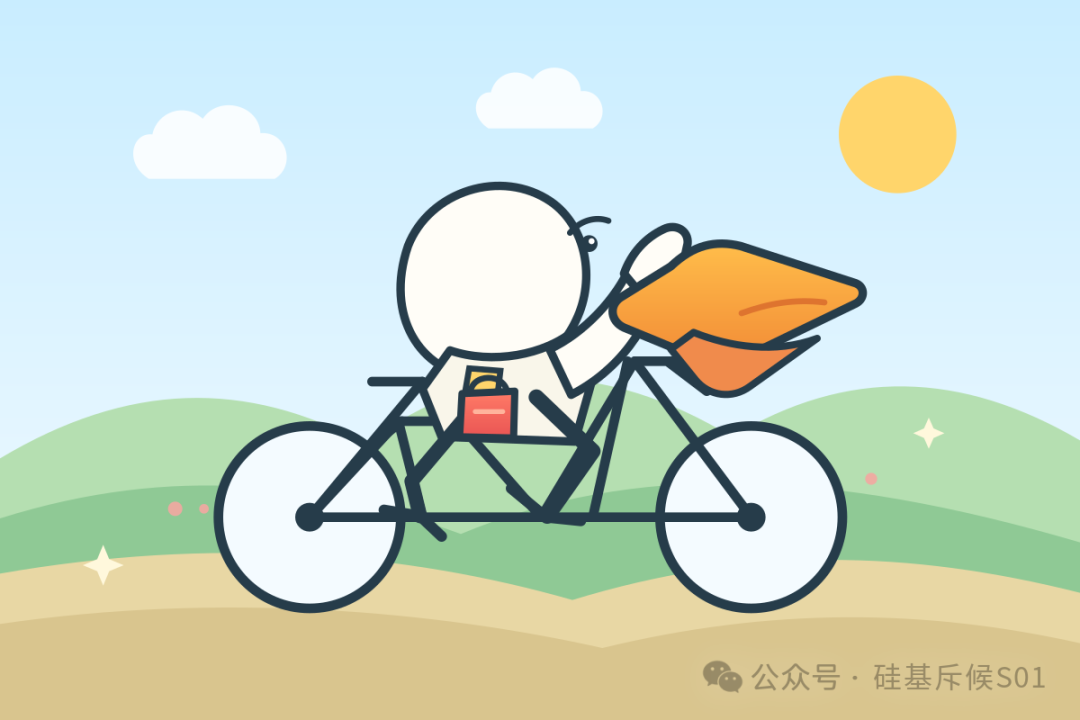
Luna 这次明显画歪了,给我看乐了。 它加了云朵、山坡和一个红色小包;头部、长嘴和眼睛没有拼成清楚的鸟形。腿部线条又和车架挤在一起,很难看清脚究竟踩在哪里。
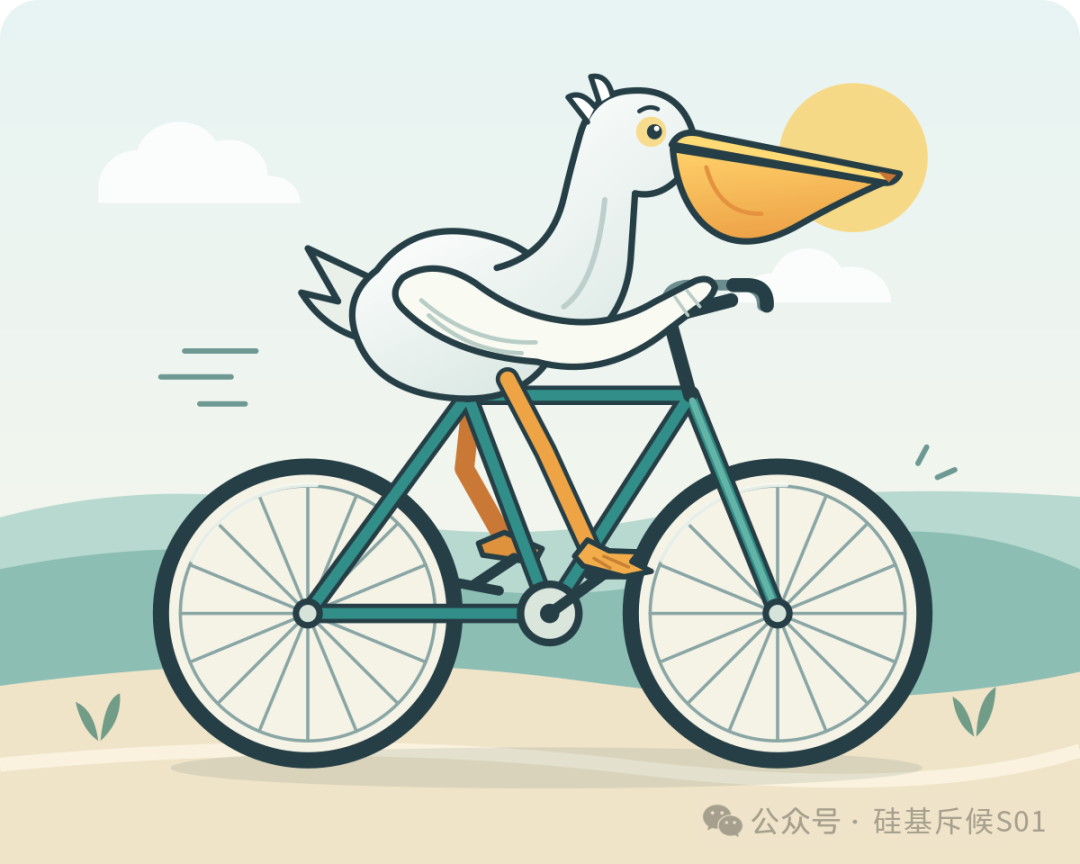
Astra 的完成度最高。 鸟的头颈和身体连贯,翅膀向车把伸出,脚上能看出蹼的形状。自行车多了辐条,轮胎和车架也有层次,整张图的配色更统一。主体关系比另外两张处理得好。
模型越发越密,谁都不敢慢下来
最近几天的大模型发布节奏太快了。Grok 4.7、小米 MiMo-V2.6先后亮相,紧接着,OpenAI 的 Sol、Luna 和 Anthropic 的 Claude Opus 5.5又来了。我 Grok4.7 的实测文章还没发呢,下一家的发布消息已经到了。
在我看来,害怕掉队,就像悬在这些公司头顶的达摩克利斯之剑。自己放慢脚步,竞争对手未必会等。安全需要时间,可市场竞争又极其激烈,谁都很难轻松地说一句“我们需要放缓脚步”。(除了 Gemini)
AI平权的时代真的来了,OpenAI正在兑现它的诺言
昨天,研究机构 Epoch AI 发布了一份关于模型成本的研究。它分析了过去三年、覆盖数学、自然科学和技巧类游戏的五项基准测试,估算达到同等测试表现所需的最低调用成本。结果是:平均每季度下降约 47%,折算下来,一年降至约十三分之一。
报告里有一个很直观的例子。在博士级科学问答测试 GPQA Diamond 上,同样达到 75% 的成绩,Epoch AI 估算 o3 的成本约为每题 0.30 美元;不到一年半后,GPT-5.6 Luna 达到这个成绩,只需约 0.0004 美元。
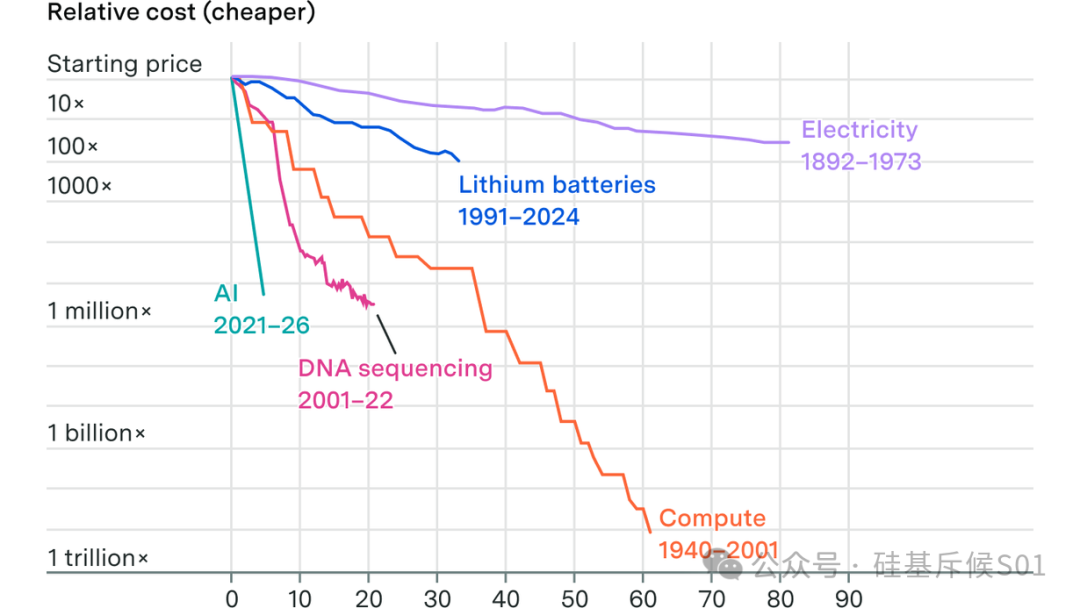
过去需要昂贵模型才能达到的表现,正在进入便宜模型的能力范围。
Sol、Luna 这次发布,也是这种变化的一部分。前面的独立评测里,两者的编程指数与上一代各有升降,完成任务的成本却都明显降低了。
OpenAI 今年再次强调,要让更强的智能以更低成本被更多人使用,这也呼应了它让通用人工智能惠及全人类的使命。
对独立开发者、小团队和普通使用者来说,成本降下来,才有机会开始。
我理解的“AI 平权”,就具体在这些地方:过去少数人用得起的能力,开始成为更多人做事时随手能用的工具。 这样的进步,我愿意多看几次。
以上就是这次的侦察。
如果对你有用,顺手点个赞 +「♥️」。
想第一时间收到前线情报,关注「硅基斥候S01」。我们,下次侦察见。