到今天9 月 20 日,我看页面上已经显示 Flash 结束了本轮训练,Pro 还在继续训练。
Flash 从 9 月 15 日夜间运行到 9 月 19 日 10:22,持续约 83 小时,完成 30 步训练,累计估算费用停在 85.40 万美元。
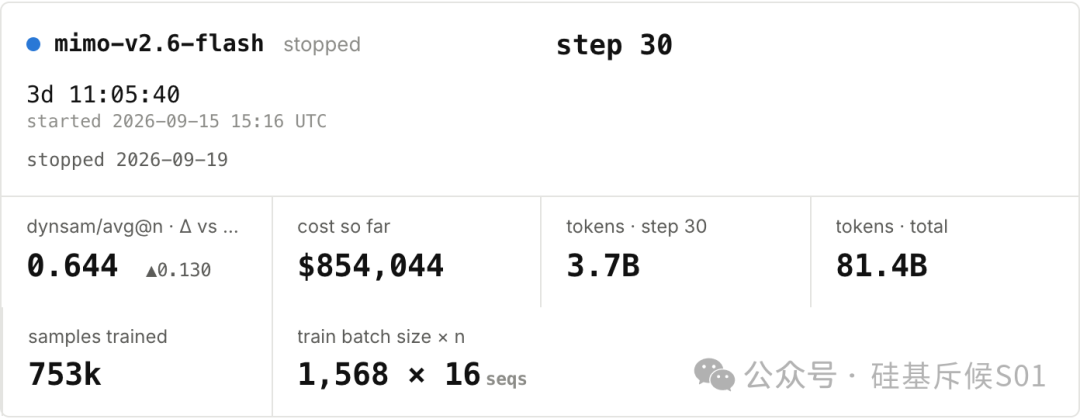
Flash 已停止,费用约 85.40 万美元。来源:小米训练看板。
Pro 还在继续训练,已运行四天多,完成 27 步,估算费用达到 **230.13 万美元。**两者目前合计 315.53 万美元。这不过这只是小米自己的统计口径,并没有公开硬件、数据和人工的分项账单。
一个已经会聊天、会写代码的大模型,为什么还需要这么贵的“补课”?
Flash 花掉的这 85 万美元,究竟换来了多少进步?沿着训练过程看下去,才能看清算力、数据和人工分别在忙什么,以及谁在提供这些工作。
先看这笔钱换来了什么。
小米重点公布了三项成绩。
其中,DeepSWE 会让模型处理真实开源项目里的工程问题。模型要看懂代码、修改文件,再接受程序检查。AutomationBench 则把客户管理、邮件、日历等应用放进模拟环境,看模型能否完成销售、客服、财务等工作。比如需要跨几个系统查资料、改状态的任务,最后要检查事情是否办对。
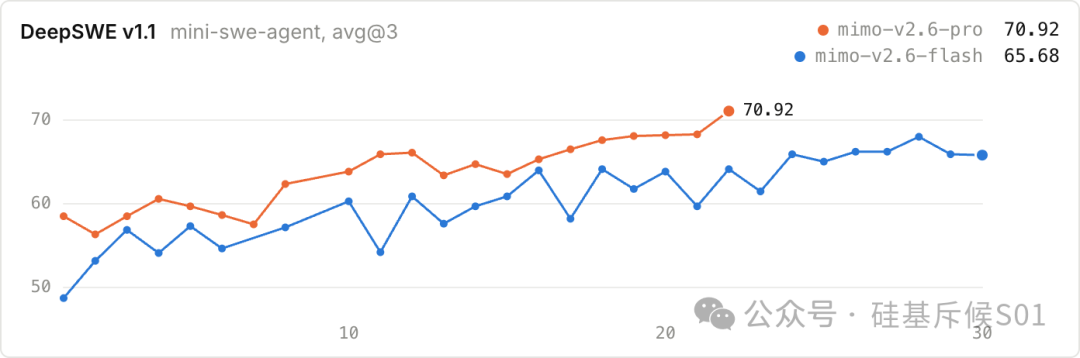
DeepSWE 评测曲线,9 月 20 日截图。
测什么
Pro:起点 → 最新
Flash:起点 → 最新
软件工程任务(DeepSWE)
58.41 → 70.92
48.67 → 65.68
小米内部代码测试
57.54 → 64.44
53.83 → 62.87
业务流程(AutomationBench)
45.20 → 51.00
44.80 → 52.70
这些是小米公开的评测数据,起点已经进入强化学习阶段;Pro 的最新成绩对应第 22 步,Flash 对应第 30 步。两种模型在三项评测上都比起点提高了,Flash 的软件工程成绩增加约 17 个百分点。
但进步并不平滑。Flash 在这项软件工程测试中,第 28 步曾拿到 67.86 分,到第 30 步又回到 65.68 分。费用随着运行时间累计,成绩却可能上下波动。怎样让下一批练习更有用,是训练团队一直要面对的问题。
后训练要继续改善的,就是模型面对具体任务时的表现。
一轮训练,里面装着两万多次尝试。
这些练习有不同做法。训练团队可以给模型看好的示范,让它学习怎样回答;也可以让它比较不同答案;小米这次公开的强化学习,则让模型亲自尝试,再根据结果改进。
以修复一个软件问题为例,先准备好项目和任务,让模型去找相关文件、改代码、运行测试。测试报错,它就继续查、继续改。一次尝试结束后,再检查修改有没有解决问题,把结果用于下一次训练。
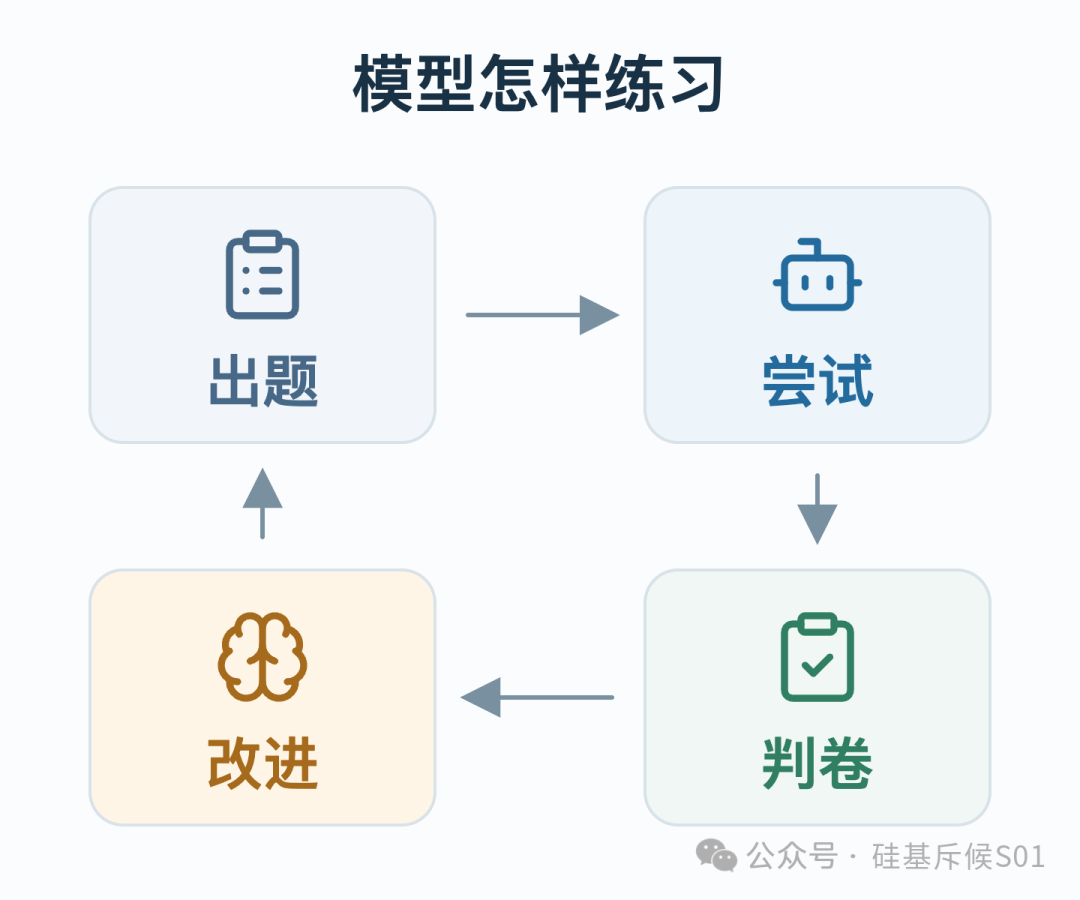
难点在于,模型往往需要试很多遍。
罗福莉公开的规模是:每一步安排 1,568 个任务,每个任务尝试 16 次。乘起来,一步就是 25,088 次完整尝试。每次又可能包含几十轮读文件、运行工具、检查结果。看板上只前进了一小格,后台已经忙了很久。
这些练习还会混合不同类型的任务,让模型在写代码、使用工具、处理其他问题时都能得到反馈。出题之后要让它跑起来,跑完还要有人或程序判卷,整个过程都在消耗计算资源。
题也得跟着模型的能力变。9 月 19 日,小米更新了一条很短的公告:筛掉对当前 Pro 模型来说偏简单的任务。
模型练到一定程度,继续重复太容易的题,训练价值就可能下降;团队需要把有限的时间留给更值得练的任务。哪些题该留,哪些题该换,也成了训练工作的一部分。
费用按小时增加,进步却没有固定单价。
Pro 和 Flash 同时运行时,看板设定的费用合计每小时约 3.08 万美元。Flash 本轮运行结束后,Pro 继续以每小时 20,556 美元累计,折合每天约 49.33 万美元。以这样的资源规模连续跑几天,百万美元很快就到了。
算力花在整套练习过程里:模型尝试不同解法要计算,运行代码、浏览器或其他工具要资源,检查结果也可能调用另一个模型。最后,训练系统还要根据这些反馈调整正在学习的模型。
如果租云资源,这些工作进入服务账单;如果用自有机器,也要承担设备折旧、电力和运维。让模型多试几遍、把任务做得更长,都会把需要处理的工作量推高。
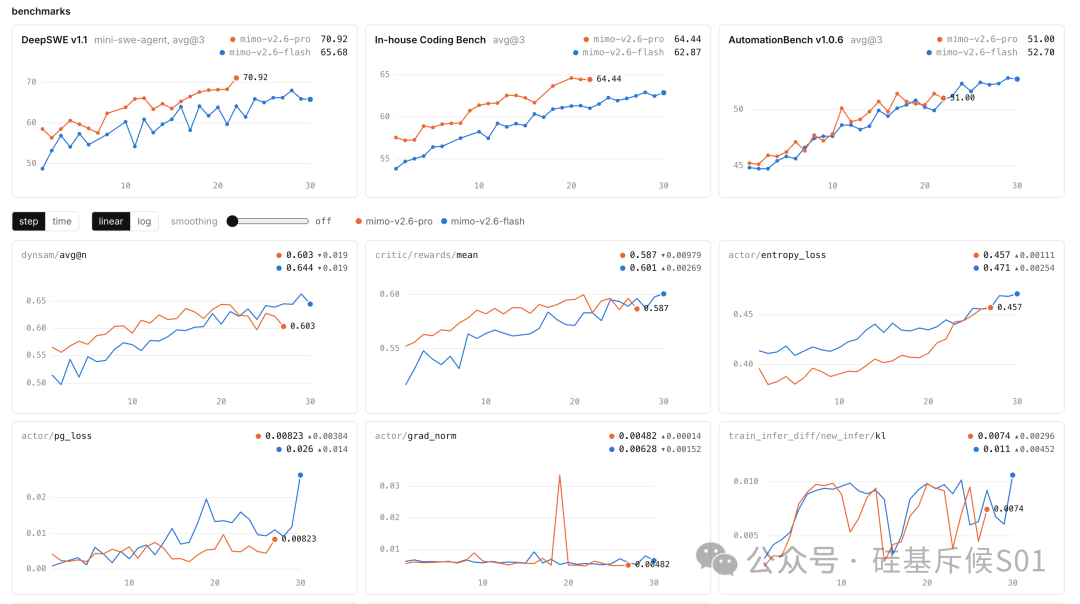
这让训练系统的工程质量变得很值钱。少中断一次、少返工一批任务,同样的设备和时间,就可能留下更多有用的训练结果。
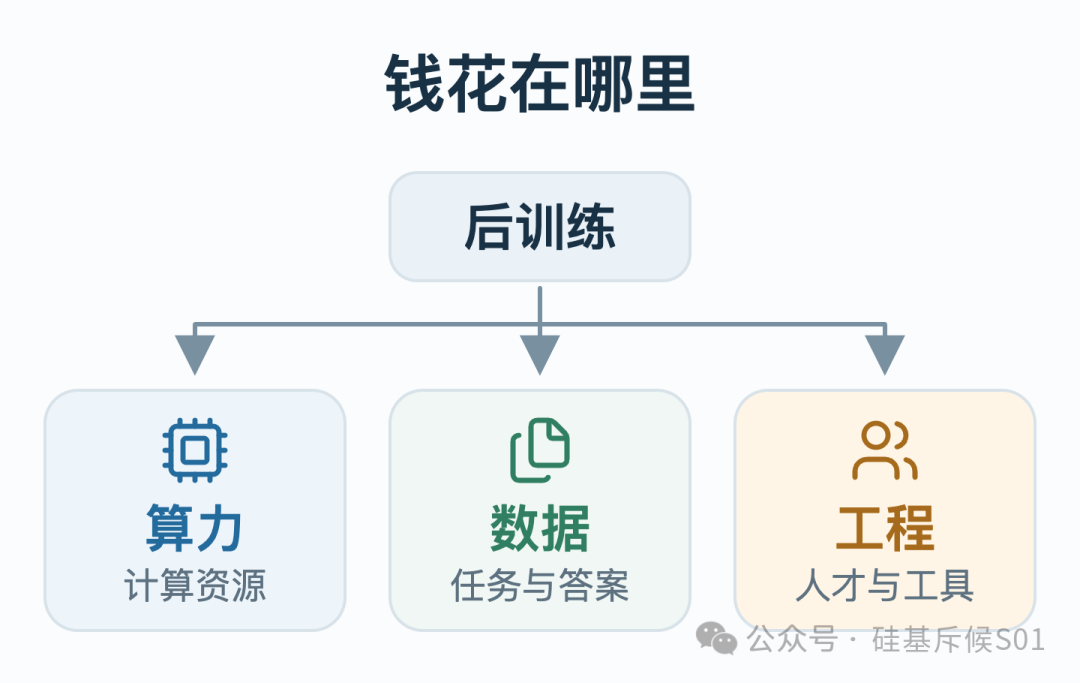
后训练的成本都花在哪里了?
其实从网上收来一堆资料,到模型可以拿它练习,中间还有不少工作。
假设要训练模型处理售后工单,获取一张真实工单数据只是起点。
还得准备相应的订单信息、退款规则、可用操作,以及一个明确的完成标准。客户要求退款,模型查完资料后究竟该退、该拒绝,还是交给人工,需要有可靠答案。
这些答案往往要请懂业务的人来确定。专家负责出题、写示范、审结果;数据人员负责清洗重复记录、整理格式、筛选样本。模型回答得流畅不等于业务办得正确,判卷质量会直接影响它学到什么。
也就是说,真正高质量的训练数据,还是缺少不了人类的参与。
这也能解释,为什么有人会对中转站的用户对话日志感兴趣。我用过的一家中转站,站主曾告诉我,有人找他买这些记录。
真实对话能暴露用户到底想干什么、模型经常在哪里卡住。如果记录里还有反复修改、工具操作和最终结果,就多了判断答案好坏的线索。这才是有高价值的人类反馈数据。
后训练的上下游产业链
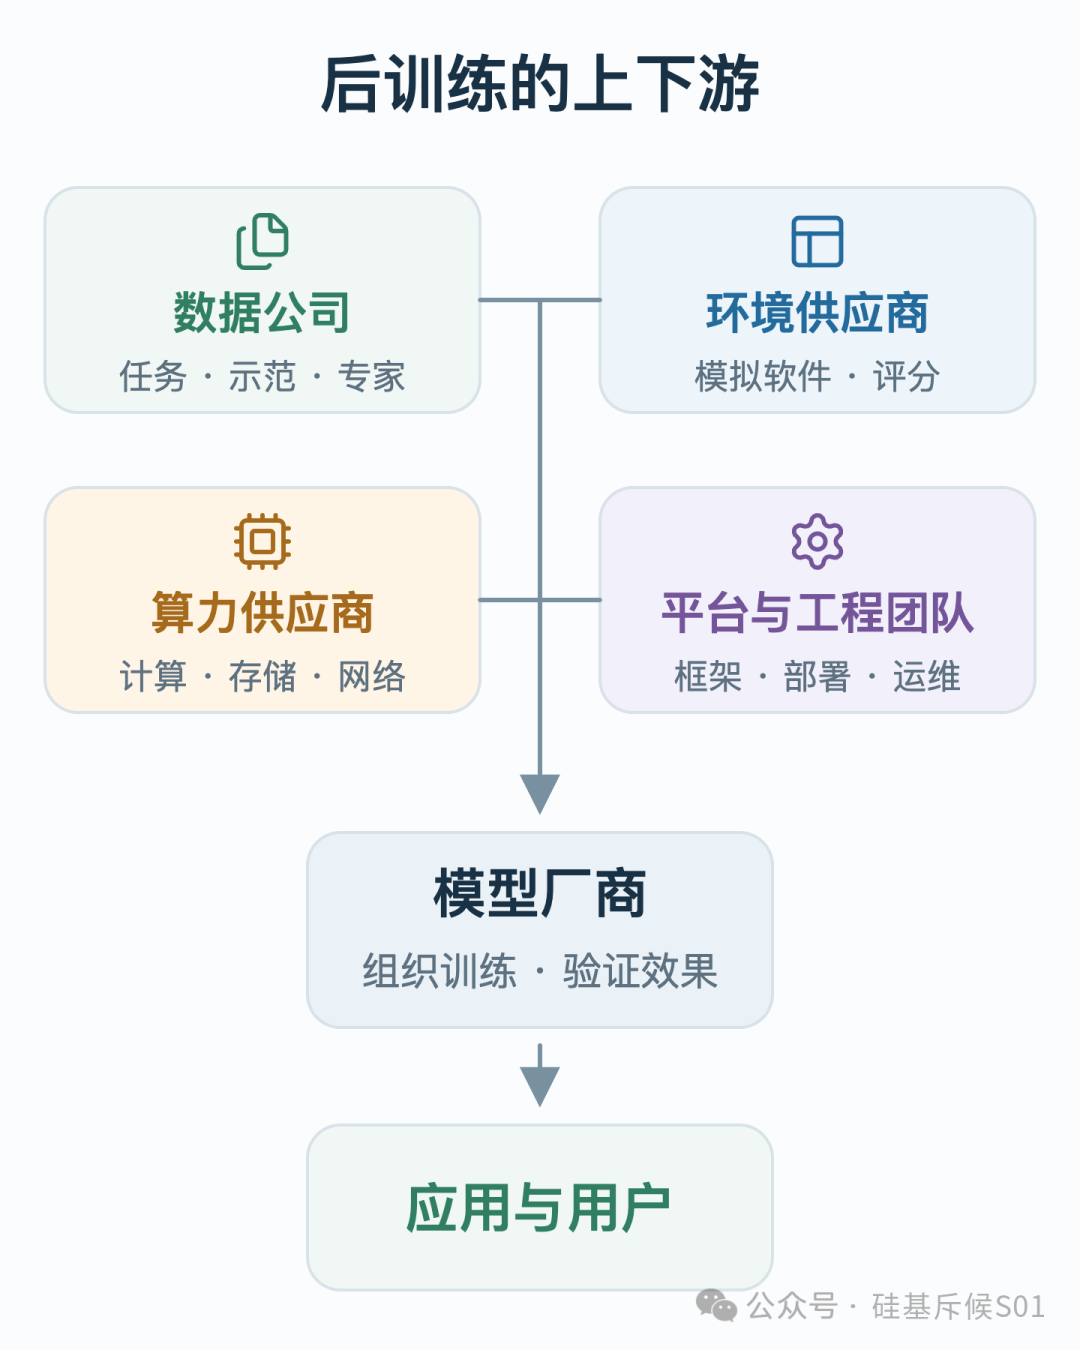
后训练产业分工示意。
数据公司可以组织专家,把有使用权限的资料加工成示范、练习题和评分标准。买方最终关心的是模型有没有受益。像数据供应商 Surge 的部分合作计划,就允许客户先训练,达到约定效果后再付费。
有人把整个模型训练的过程做成产品。Scale 就提供的强化学习环境,包括模拟应用、任务所需资料、目标和评分程序,还支持把环境恢复到起点,让模型反复练习。
仍然拿售后工单举例:供应商需要做出能查询订单、修改状态、处理退款的模拟系统。模型办完一次,就能检查有没有违反退款规则;恢复初始状态后,下一次尝试又能开始。这类交付会用到后端开发、软件测试和业务分析,懂具体行业的人也能参与。
还有团队负责把大量练习稳定地跑起来。verl 这样的开源框架提供训练实现,企业围绕它还要做部署、适配、监控和故障恢复。框架可以直接拿来用,工程人员仍然要把自己的模型、任务和运行环境接进去。
这就是后训练费用会流向外部团队的原因。模型厂商要让模型变强,围绕它需要持续提供好题、可靠的判卷和稳定的练习条件。算力供应、数据加工、专家服务和训练工具,都有各自的交付物。
在现有的大模型技术框架下,后训练正成为推动模型能力快速提升的关键手段。小米这场直播,让我们直观看到了这个过程:几天时间,经过一轮轮尝试,在315 万美元的加持下,Pro 和 Flash 在多项评测上都有了明显进步。
接下来,就看这些训练成果能给实际使用带来多少惊喜了。让我们期待 MiMo-V2.6 的最终表现。
以上就是这次的侦察。
如果对你有用,顺手点个赞 +「♥️」。
想第一时间收到前线情报,关注「硅基斥候S01」。我们,下次侦察见。